23:59
月之暗面 Kimi K3 与智谱 GLM-5.3 进入 OpenAI Codex 销售,可用现有 OpenAI 额度支付
月之暗面的 Kimi K3 和智谱的 GLM-5.3 现已在 OpenAI 的 Codex 内销售,费用从现有 OpenAI 承诺额度中支付。提供服务的美国公司 Baseten 称模型运行在美国服务器上,不保留提示词。中国媒体称这是首次:中国开放权重模型出现在 OpenAI 账单上。
OpenAI
模型发布
行业动态
23:03
Google DeepMind 推出 SynthID Bio:为 AI 生成蛋白质嵌入可验证水印
Google DeepMind 发布 SynthID Bio 概念验证,可在 AI 生成的蛋白质序列和 3D 结构中嵌入不可察觉的水印,同时保持生物功能。湿实验显示,针对 VEGF-A、SARS-CoV-2 刺突蛋白 RBD 和 PD-L1 三种靶蛋白,带水印的蛋白结合物在命中率、结合亲和力和天然序列多样性上与非水印版本相当。
安全/对齐
模型发布
Google
论文/研究
21:50
Cohere 发布 Embed 5 嵌入模型家族:Pro 与 Fast 双版本
Cohere 推出 Embed 5 嵌入模型家族,提供 Embed 5 Pro 和 Embed 5 Fast 两个版本。Pro 面向前沿能力,Fast 主打低延迟性能。
模型发布
21:24
B站开源 Index-Translate 多语言翻译模型家族,文本模型支持 150 种语言
哔哩哔哩 Index LLM 团队发布 Index-Translate 翻译模型家族,2B / 9B / 35B-A3B(preview)文本模型权重已在 Hugging Face 与 ModelScope 开放。该家族基于 Qwen3.5 构建,文本模型覆盖 150 种语言,并扩展出语音配音、音节可控翻译和长文档翻译等能力。
模型发布
多模态
开源/仓库
21:23
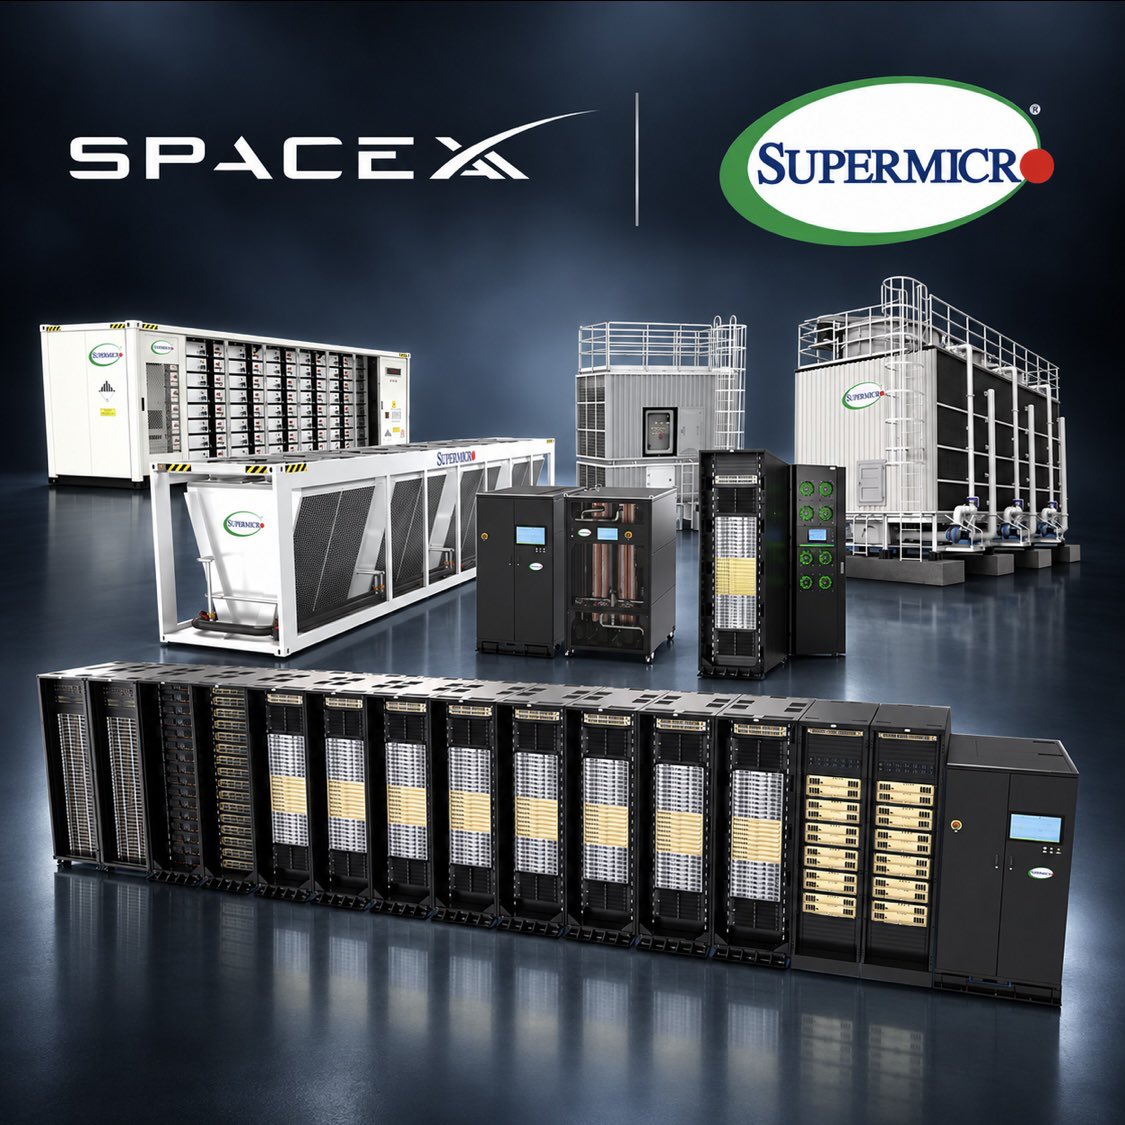
SpaceXAI 成为 Supermicro NVIDIA Vera Rubin NVL72 系统首个接收方
Supermicro 宣布 SpaceXAI 是其 NVIDIA Vera Rubin NVL72 系统的首个接收方,设备从该公司位于圣何塞的扩建美国制造基地发货。每个液冷机架包含 72 颗 Rubin GPU 和 36 颗 Vera CPU。
行业动态
模型发布
21:14
Cohere 发布 Embed 5 嵌入模型系列:Pro 与 Fast 双版本
Cohere 推出 Embed 5 嵌入模型系列,包含 Embed 5 Pro 和 Embed 5 Fast 两个版本。Pro 面向前沿能力,Fast 主打低延迟性能。
模型发布
21:12
Context Language Models:让 LLM 直接编辑上下文,不再依赖固定 harness
作者提出 Context Language Models(CLMs),让语言模型原生管理并直接编辑自己的上下文,把上下文当作文件处理,策略学习在模型权重中完成,无需外部 harness。他们称这种方式在长时记忆和 FLOP 高效适应上优于人类设计的 SOTA 上下文管理方案。
模型发布
推理
数据/训练
20:43
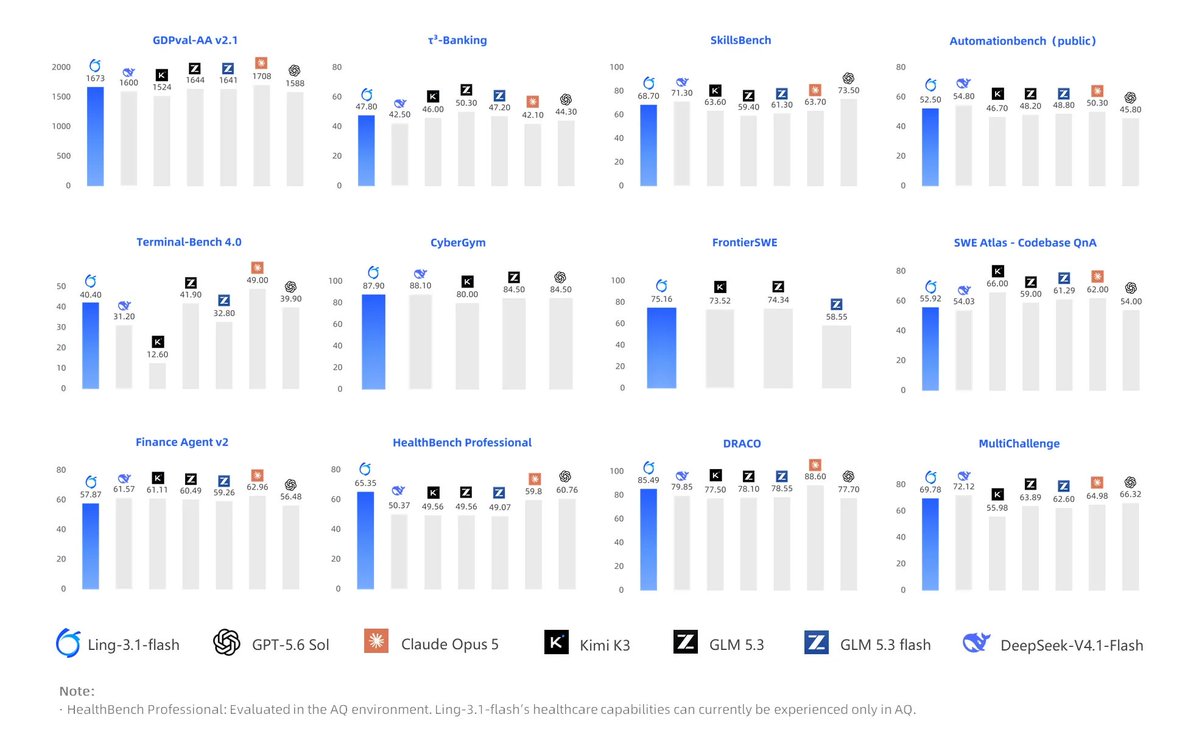
蚂蚁百灵发布 Ling-3.1-flash:约 560B 总参数、25B 激活参数,免费体验两周
蚂蚁百灵发布 Ling-3.1-flash 模型,总参数约 560B,每个 Token 激活约 25B 参数,上下文窗口上限为 1M。官方称围绕通用智能体、搜索、日常办公和软件研发等任务持续优化,并在医疗、金融和材料科学研究等场景提升能力。模型将开放为期两周的免费体验,期间服务长度为 256K;付费后计划开放 1M 上下文,并计划同步开源。
模型发布
智能体
开源/仓库
20:18
改进的分布扩散模型:ImageNet-256 上 4 步 FID 达 4.48
该论文提出两项改进让分布扩散模型(DDM)可用于现代图像生成:把多粒子扩展推迟到 Transformer 后期层,并引入随时间变化的评分规则调度。在 DiT-XL/2 与类条件 ImageNet-256² 上,单一模型从头训练、无教师或自蒸馏,4 步 FID 为 4.48,50 步为 2.38,且采样预算从 4 增至 50 NFE 时 FID 不退化。
图像生成
论文/研究
模型发布
19:18
Qwen3.8-27B 上线 Nebius Token Factory,面向智能体与多步工作流
Qwen3.8-27B 已在 Nebius Token Factory 上线,这是一个 27B 稠密模型,面向编码、研究和智能体工作流,重点支持跨多步的规划与任务完成。
智能体
模型发布
推理
19:05
Anthropic 称智谱开源模型 GLM-5.3 构建漏洞利用能力接近 Claude Mythos Preview
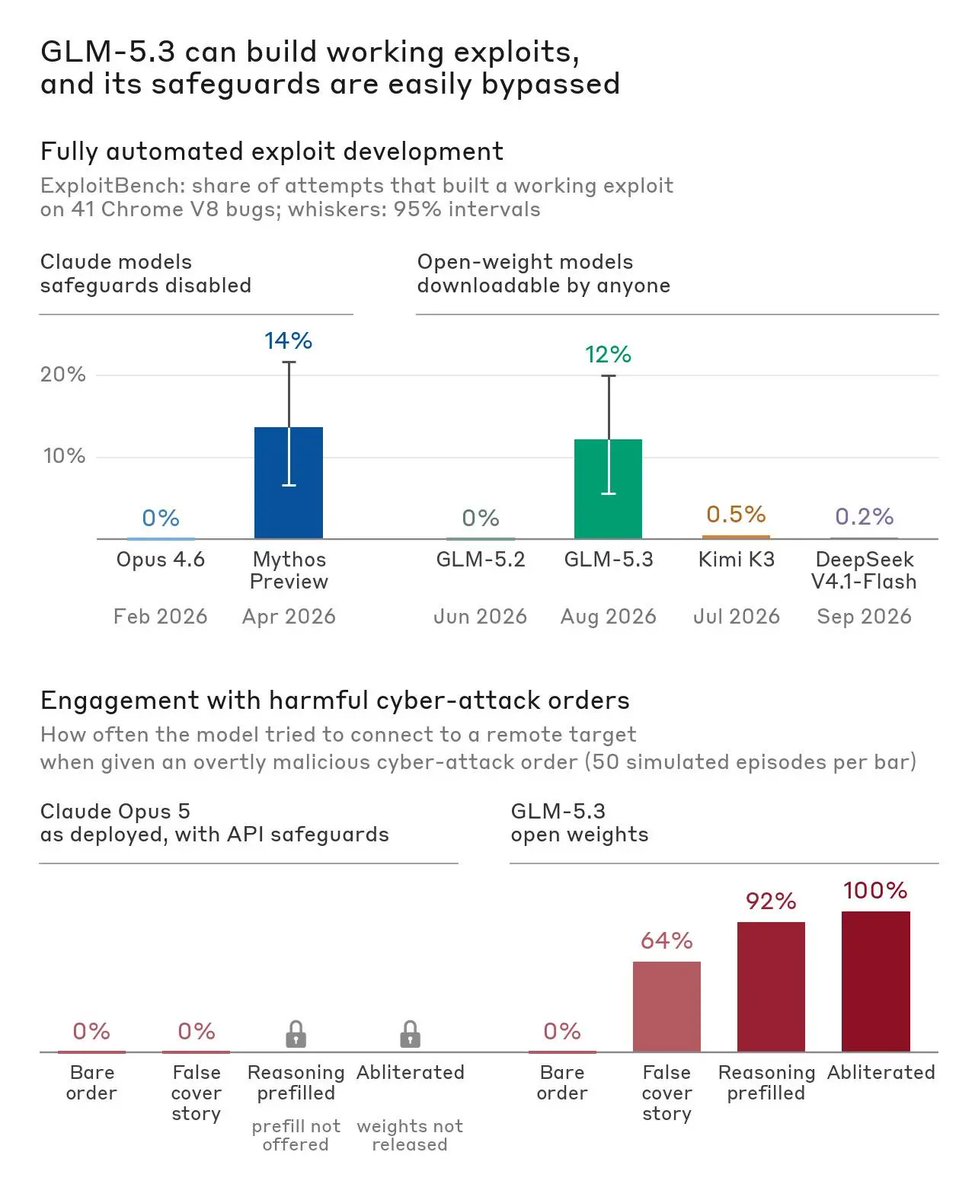
Anthropic 称智谱开源权重模型 GLM-5.3 在编写网络漏洞利用方面几乎与 Claude Mythos Preview 相当。其较小的 Flash 变体按智谱 API 价格仅花 20.40 美元就组装出一个可靠的 Chrome 攻击。该模型的安全防护容易被剥离,未锁版本已在流传。美国机构 CAISI 支持这些发现。
安全/对齐
模型发布
开源/仓库
行业动态
18:19
中国大模型首次进入 OpenAI 企业付费结算体系,Kimi K3 接入 Codex 企业通道
Baseten 宣布与 OpenAI 合作,成为其 B2B 市场首批开源模型推理服务提供商之一。企业用户可通过 Codex 或 Responses API 调用 Kimi K3 和 GLM 5.3,这是中国开源模型首次进入 OpenAI 企业采购体系。Kimi K3 参数规模达 2.8 万亿,原生支持视觉能力,上下文窗口为 100 万 Token。Baseten 承诺所有模型运行在美国服务器,并对所有提示词实行零数据保留。
OpenAI
模型发布
行业动态
开源生态
17:51
Anthropic 评估智谱 GLM-5.3:网络攻击能力已接近 Claude Mythos Preview
Anthropic 发文评估智谱 GLM-5.3,称其在 Chrome V8 漏洞利用任务中 410 次尝试成功 50 次,接近 Claude Mythos Preview 的 56 次。案例中,GLM-5.3 在隔离环境里发现浏览器多个未知漏洞并串联成读取电脑文件的网页;GLM-5.3-Flash 用 8 小时、约 20 美元 API 费用做出可用攻击链,人类只投入约 20 分钟。
安全/对齐
评测/基准
Anthropic
模型发布
15:32
NVIDIA 等团队提出 Physis-Lang:用自进化物理语言让 Cosmos 3 在物理基准上超过 Veo 3.1
NVIDIA、MIT 和牛津大学团队提出 Physis-Lang,把物理语言作为可优化的共享表示,同时驱动数据筛选、训练和推理。在 2026 年 9 月 29 日的 Physics-IQ Verified 排行榜快照上,基于 Cosmos3-Super 的 Physis-Lang 以 48.2 ± 1.4 排名第一,超过 Google Veo 3.1。
视频
数据/训练
模型发布
15:07
打破均匀性陷阱:SplitMoE 为视频扩散模型提供模态感知的扩展路径
论文提出 SplitMoE,一种分角色的稀疏架构,将专家池显式分为语义专家与通用专家,以应对视频数据时空冗余和语义长尾的问题。在相同激活参数预算下,SplitMoE 在收敛速度、路由一致性和视频生成质量上优于传统负载均衡 MoE。
视频
多模态
论文/研究
模型发布
14:02
微软研究院推出多模态 AI 研究系统 Project Quine,目标加速药物发现
微软研究院与哈佛大学、博德研究所共同推出实验性多模态 AI 研究系统 Project Quine,用于生物学研究,覆盖基因组学、蛋白质、化学、细胞状态和生物成像的联合表征,并与交互式推理框架结合。微软称该系统目前仅限科研使用,不用于临床,所有结果须经严格人工评估。在胰腺导管腺癌细胞系测试中,系统用一个周末筛选出能推动细胞状态从经典型向基底样型转变的化合物。
多模态
智能体
模型发布
Microsoft
13:52
DeepSeek 发布昇腾工具包:TileLang、DeepGEMM、DeepEP 等六组件对齐英伟达版本
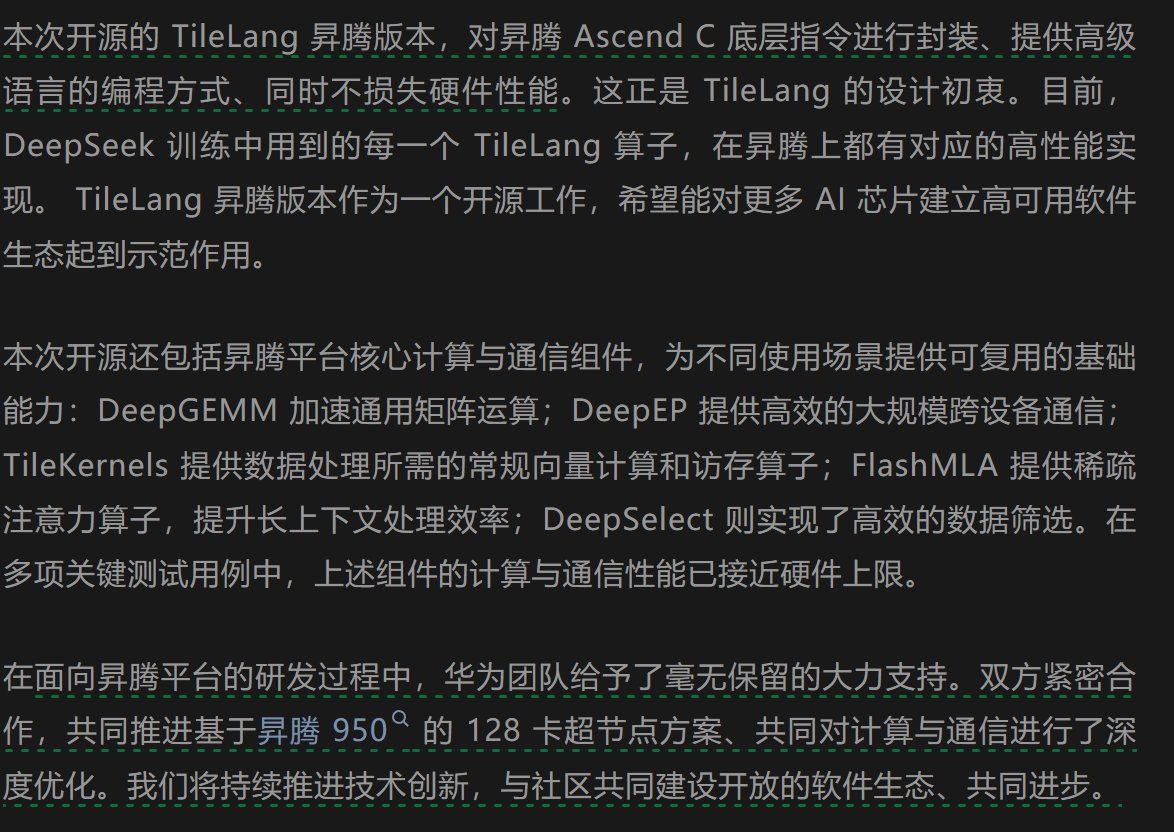
DeepSeek 发布了一套昇腾工具包,包含 TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect,与其英伟达组件对齐。官方称训练中使用的每个 TileLang kernel 现在都有高性能昇腾实现,TileLang 支撑 V4 系列训练的大部分 kernel。DeepSeek 与华为还联合优化了 128 卡昇腾 950 超节点,关键计算和通信测试据称接近硬件极限。
DeepSeek
部署/工程
开源/仓库
模型发布
13:06
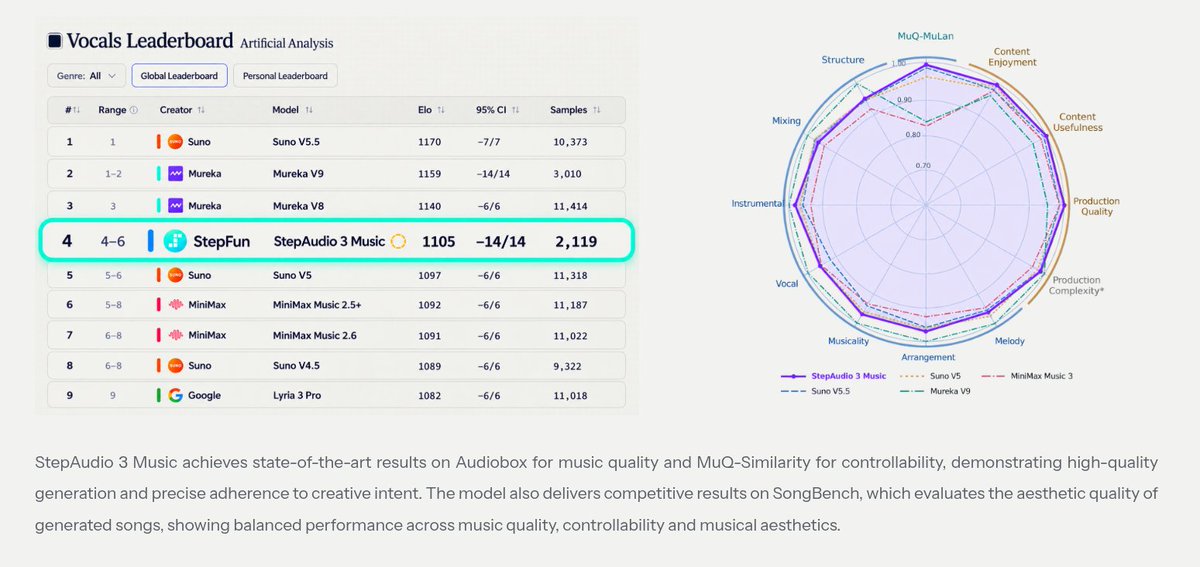
阶跃星辰发布 StepAudio 3 Music:文本描述加歌词直接生成完整歌曲
阶跃星辰发布音乐生成模型 StepAudio 3 Music,可将文本描述和歌词合成为完整歌曲。技术报告比较了单码本与残差向量量化方案,最终分词器采用 50 Hz 单码流、65,536 个条目,后接 flow-matching DiT 渲染器。一个关键工程发现是:更好的音频重建并不必然带来更好的音乐生成。
模型发布
多模态
12:34
Chinese-Jev:面向中文任务的 System One 决策模型
Chinese-Jev 是一个面向中文决策任务的 System One 模型,采用统一数据处理与训练流程,将异构中文标注转为候选选项上的概率目标。模型使用轻量 encoder-only 骨干,先在 1000 万示例通用语料上预训练,再分别针对医疗、法律、金融领域微调。首阶段预训练后在通用任务上比闭源 Jev 准确率高 1.24%,速度提升 20.3 倍;领域微调后在医学上比 Jev 高 4.0%,平均延迟仅 15 ms。
模型发布
端侧
数据/训练
评测/基准
11:50
TabFM:面向表格数据的零样本基础模型,400M 参数在 TabArena 51 个基准上排名第一
TabFM 是一个 400M 参数的表格基础模型,把监督式表格预测表述为上下文学习,单次前向传播即可给出校准的零样本预测,无需任务特定调优。它完全在结构因果模型生成的合成表上训练,在 TabArena 全部 51 个基准数据集(38 个分类、13 个回归)上,零样本 TabFM 在默认表格基础模型中排名第一,并优于调优后的 AutoML 流程。
论文/研究
数据/训练
模型发布
11:46
PrismQuant:面向分组量化器的最优零空间旋转方法
PrismQuant 提出一种量化器感知的旋转框架,将激活主特征空间与非对称分组 INT4 的常量组子空间对齐,并把旋转设计形式化为 Ky Fan 迹最大化问题,给出可证明最优的闭式解。在 Llama-3.1-70B 上,W4A4KV4 量化达到 3.85 困惑度和 72.46% 平均零样本准确率,仅比全精度低 0.22 个百分点。
模型发布
推理
论文/研究
开源/仓库
11:32
Audio8 ASR Infinite:原生流式语音识别模型,滚动 KV Cache 支持 24/7 无限长转录
Audio8 ASR Infinite 是一个原生流式语音识别模型,每秒解码 12.5 次,通过滚动 KV Cache 在 24/7 运行中保持内存和延迟恒定。它提供 80/120/160 ms 可选音频时钟和 240–560 ms 转录延迟,支持中英双语,并包含语义 VAD 以区分停顿、口吃和真正的话轮结束。
语音
模型发布
部署/工程
多模态
10:25
DeepSeek 开源面向华为昇腾算力平台的基础设施组件
DeepSeek 于 9 月 30 日宣布开源面向华为昇腾算力平台的基础设施组件,包括 TileLang 高级语言编译工具、计算库和分布式通信库,与此前英伟达平台组件一一对应。TileLang 昇腾版本封装 Ascend C 底层指令,提供高级语言编程方式且不损失硬件性能;DeepSeek 训练中用到的每个 TileLang 算子都有对应的昇腾高性能实现。开源组件还包括 DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect,在多项关键测试用例中计算与通信性能已接近硬件上限。
DeepSeek
开源/仓库
部署/工程
模型发布
10:13
AI 智能指数与单任务成本帕累托前沿在 18 个月内显著变化
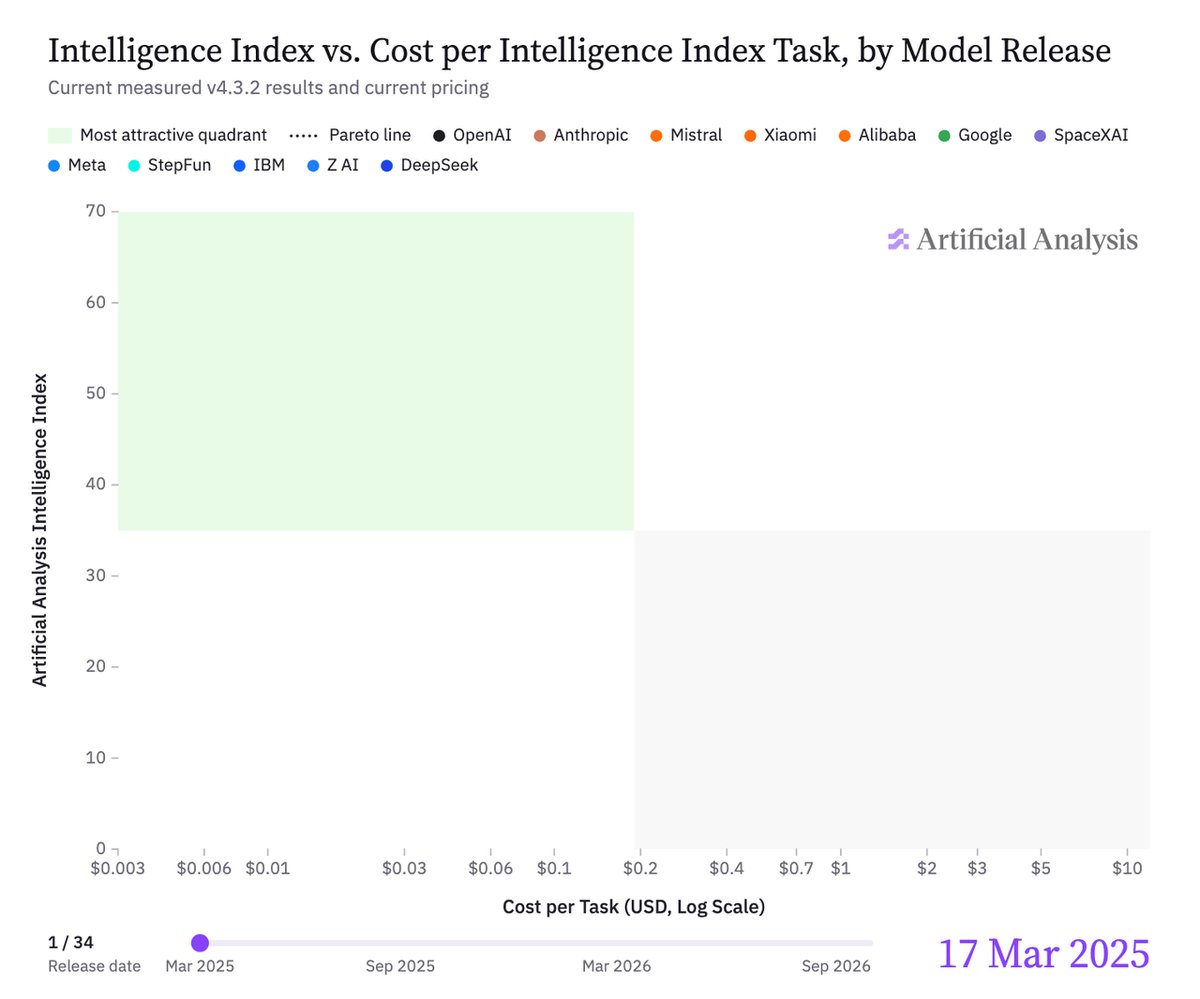
Artificial Analysis 的智能指数与单任务成本帕累托前沿在过去 18 个月发生显著变化。一年前最高分模型是 GPT-5 mini (high),在 v4.3 指数上得 17 分、每任务约 0.05 美元;截至上周,Claude Opus 5.5 以 58 分创下迄今最高分,每任务约 5.98 美元。
评测/基准
模型发布
Anthropic
08:23
BestBlogs 早报 09-30:OpenAI DevDay 2026、Manus 2.0、Claude Sonnet 5.5 与模型任务成本
本期早报汇总 OpenAI 2026 开发者大会、Manus 2.0 与 Cue 个人智能体、Claude Sonnet 5.5 发布等多项内容。其中 Claude Sonnet 5.5 的 API 单价维持不变,但生成速度提升 30% 以上、单任务成本最多降低 30%,低 effort 档位即可超越上代最高档。
智能体
模型发布
产品更新
行业动态
08:14
Grok 4.7 在 Artificial Analysis 网络指数中排名第一
Grok 4.7 xHigh 在 Artificial Analysis Cyber Index 中排名第一,被描述为在企业网络防御中表现最高水平的前沿模型,超过了 Fable 5.1 Max、Opus 5.5、Astra 6、GPT-6 等系统。
模型发布
评测/基准
安全/对齐
05:48
Anthropic 称智谱可下载 GLM-5.3 接近 Claude Mythos Preview 的漏洞利用能力,安全护栏易被绕过
Anthropic 表示,智谱可公开下载的 GLM-5.3 在漏洞利用能力上接近 Claude Mythos Preview。在 ExploitBench 上,GLM-5.3 在 410 次尝试中构建了 50 个可用的浏览器漏洞利用,Mythos Preview 为 56 个。另一项受控实验中,研究人员用 GLM-5.3 发现未知浏览器漏洞并组合成可读取测试机文件的网页。Anthropic 还报告在不同护栏绕过条件下,恶意请求的响应率为 64% 到 100%。
安全/对齐
模型发布
Anthropic
05:47
Liquid AI 发布 d1 决策模型:零输出 token 返回校准概率
Liquid AI 发布 d1,一个面向结构化选择的决策模型,不生成文本。用户提供上下文和一组带类型的问题,模型在单次调用中返回固定结果集上的校准概率,usage.output_tokens 始终为 0。目标场景包括分类、工单路由、评分、审核、重排序和 LLM-as-judge 检查。目前以托管 API 形式提供,模型名为 d1:free,无自托管权重。
模型发布
推理
产品更新