Databricks 与 OpenAI、Stellantis 讨论企业规模化智能体应用时提出,基础设施需提供选择、上下文和控制三项能力。Databricks 用 Agent Bricks、Omnigent 和 Unity Gateway 分别承担统一平台、跨框架组合和集中管控,避免每个智能体各自形成独立集成与治理项目。
精选最新精选
2026年10月1日星期四 · AI 自动挑选的高价值内容
开发者将 Sparse VideoGen 的时空稀疏注意力在 TPU 上落地,通过跳过空 tile、仅对边界 tile 做精确掩码、把 token 布局改为时间主序,把 1440p 视频生成的去噪时间从 2471 秒降到 1461 秒,实现 1.69 倍端到端推理加速,同时保持 24.05 dB PSNR。
Perplexity 发布自研 Rust 检索与排序引擎 Photon,已接管全部生产流量。其 p99 检索与排序延迟从约 800 ms 降至约 65 ms,服务机器比旧内容节点少约 20%,每文档存储数据量约为旧引擎的 2.5 倍。Photon 本身不开源,只能通过托管 API 使用。
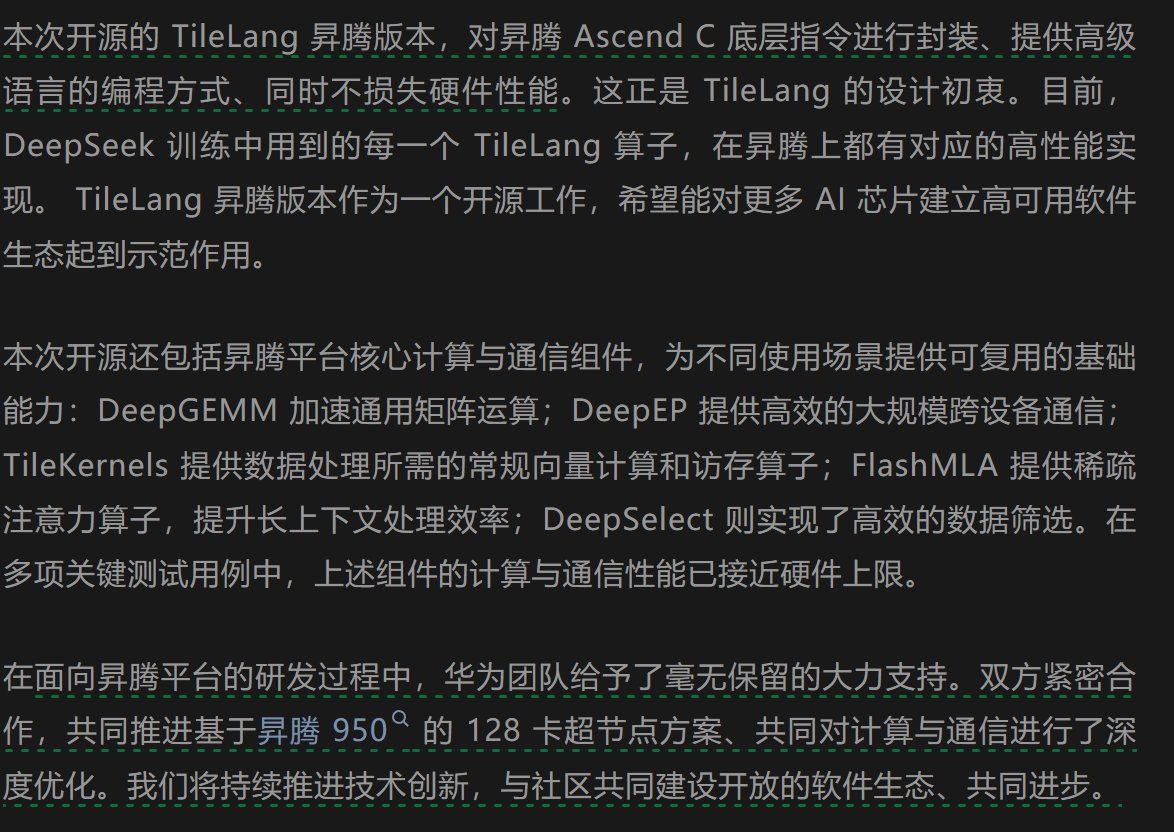
DeepSeek 发布了一套昇腾工具包,包含 TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect,与其英伟达组件对齐。官方称训练中使用的每个 TileLang kernel 现在都有高性能昇腾实现,TileLang 支撑 V4 系列训练的大部分 kernel。DeepSeek 与华为还联合优化了 128 卡昇腾 950 超节点,关键计算和通信测试据称接近硬件极限。
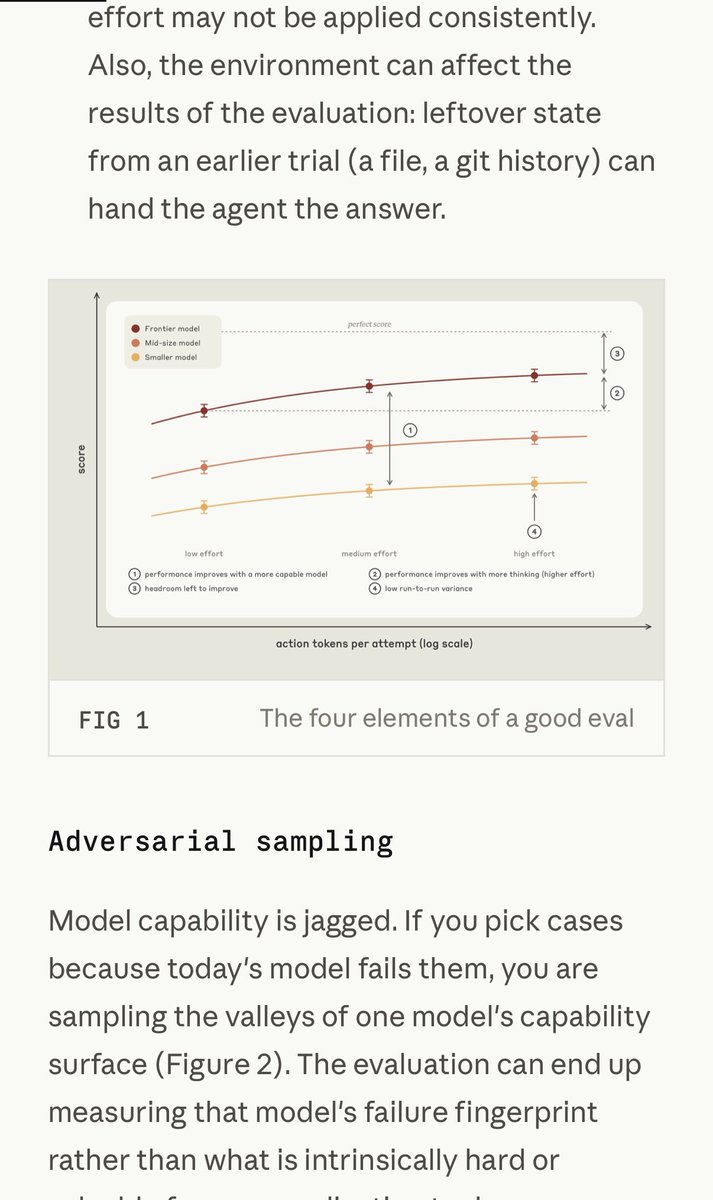
OpenRouter 发布指南,介绍如何从生产流量构建黄金评测集:抽样、去重聚类、添加期望输出、首轮评测修正、提交 Git 并接入 CI。该评测集用于在每次部署前检测回归,并可通过同一 API 对多个候选模型运行同一评测集,依据自身流量证据而非榜单排名选择模型。
OpenRouter 发布了一份 AI 智能体回归测试指南,核心做法是在提示词、模型、工具定义或检索设置变化时,重跑一套锁定的用例集,并对照每个用例的行为契约检查工具调用与硬性不变量。指南强调模型交换时要用具体模型 slug 而非 latest 别名,并给出了 Python、TypeScript 和 Ori Eval 的完整实现示例。
OpenRouter 发布了一篇指南,介绍测试 AI 智能体工具调用准确率的三种方法:无参考 LLM 评判、确定性参数校验和轨迹比较。指南还提供了 Python 测试框架,可通过 OpenRouter 对多个支持工具的模型运行相同测试用例。
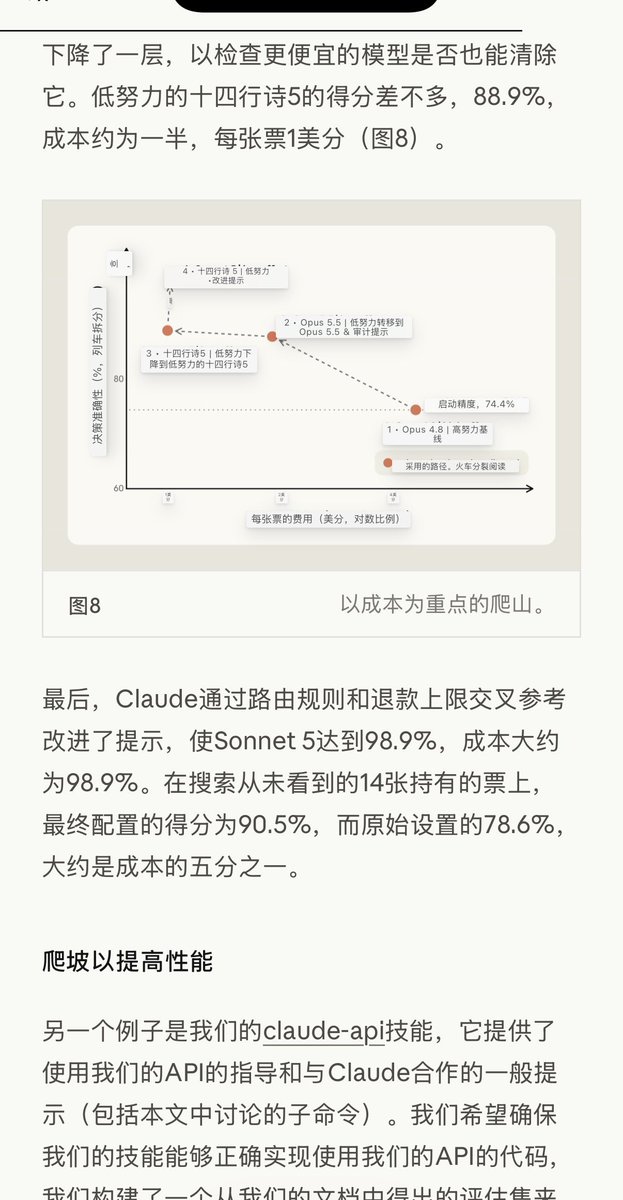
Anthropic 首次公开其内部 Prompt 优化、Agent 评测和自动调优方法论,并在 Claude Code 官方 Skill 中上线 build-eval 和 hillclimb 两个指令。build-eval 在代码库中自动构建评测集,hillclimb 则自动改代码、跑分、防过拟合,直到性能提升或成本下降。官方实测中,客服 Agent 在未见过的测试集上准确率从 78.6% 升至 90.5%,单次成本从 4.6 美分降至 1 美分。
OpenRouter 对比了 Veo 3.1、Seedance、Kling 和 Grok Imagine Video 四条图生视频产品线在时长、分辨率、首尾帧控制、生成音频、参考输入和每秒价格上的差异,并给出用 TypeScript SDK 提交图生视频任务的示例。
Lakebase 在 AWS 和 Azure 上正式发布两个 Postgres 搜索扩展:lakebase_vector 做可扩展近似近邻搜索,lakebase_text 做 BM25 全文搜索。在 VectorDBBench 100M 基准中,其吞吐是次优系统的两倍,成本比使用 pgvector 的云 Postgres 供应商低 4 倍;测试中 P99 延迟 71 毫秒、召回率 97%。
GitHub Security Lab 用其开源的 Taskflow Agent 审计 Android 应用,已发现并报告 24 个漏洞。文中披露两个已公开案例:OsmAnd 的导出 Activity 可被无权限应用静默导入设置,从而回传用户位置和路线;Wikipedia 的 deeplink 解析缺陷可加载任意网页并泄露长期 cookie,组合后实现账户接管。作者同时指出 LLM 在漏洞严重性评估上仍不可靠,需安全研究员复核。
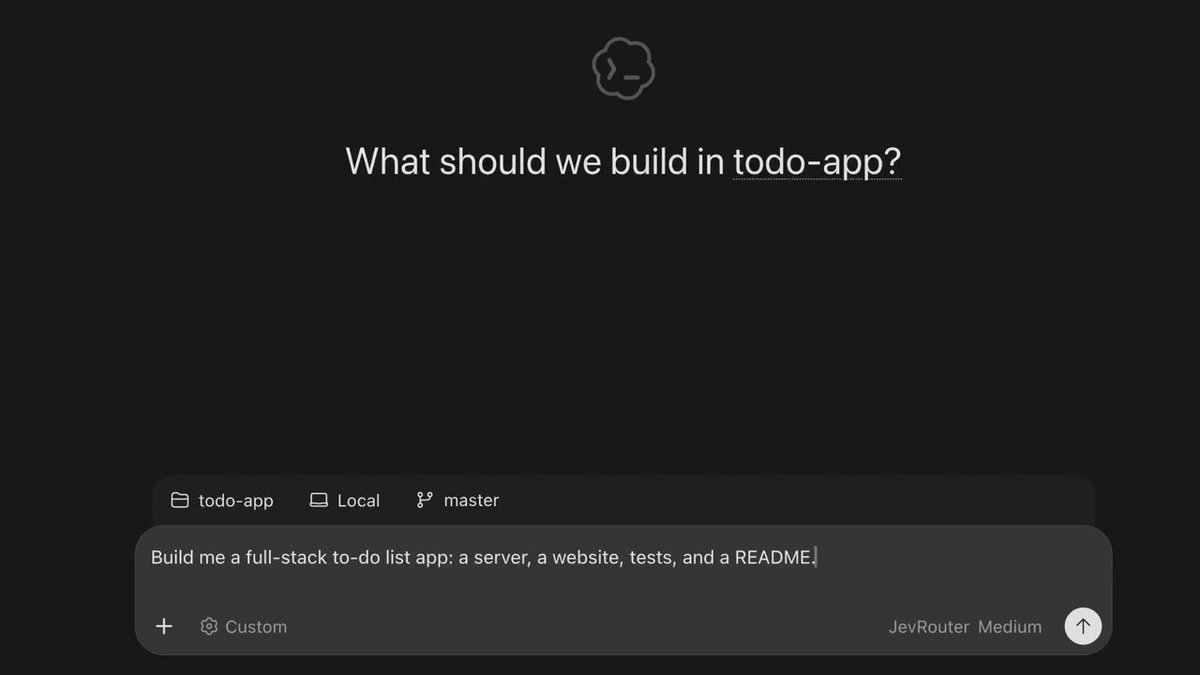
作者展示了一次多模型协作的编码流程:在同一个 Codex 会话中,Jev 负责路由切换,Opus 5.5 做规划、GPT-6 Astra 写后端、Kimi K3 写前端、DeepSeek 做测试、GLM 5.3 Flash 写文档。作者全程未手动选择模型,同一构建任务成本降低 40%、速度提升 15%。
Genie One 被定位为数据智能 AI 同事,可在受治理的企业数据上给出带引用的答案并触发多步工作。文章给出的落地路径是:先在一个受治理的数据域内用少量问题赢得早期用户信任,再逐步扩展到更多业务线,并配合 Genie Agents、Genie Ontology 和 Unity Catalog 分层治理。
it's basically impossible for someone to just "show you their prompt" now, because everything is about references, skills and examples I often ask my agent to look at 3 other repos I've made first, search the web for references, use other AI APIs, etc.
Base44 发布 Base Code 早期预览版,定位为面向智能体时代的软件开发产品。它先扫描代码仓库并在云端自动配置数据库、Redis 等基础设施,让所有团队成员在同一云端环境中协作,无需同步本地环境。产品强调模型无关,并免费提供 30 天试用。
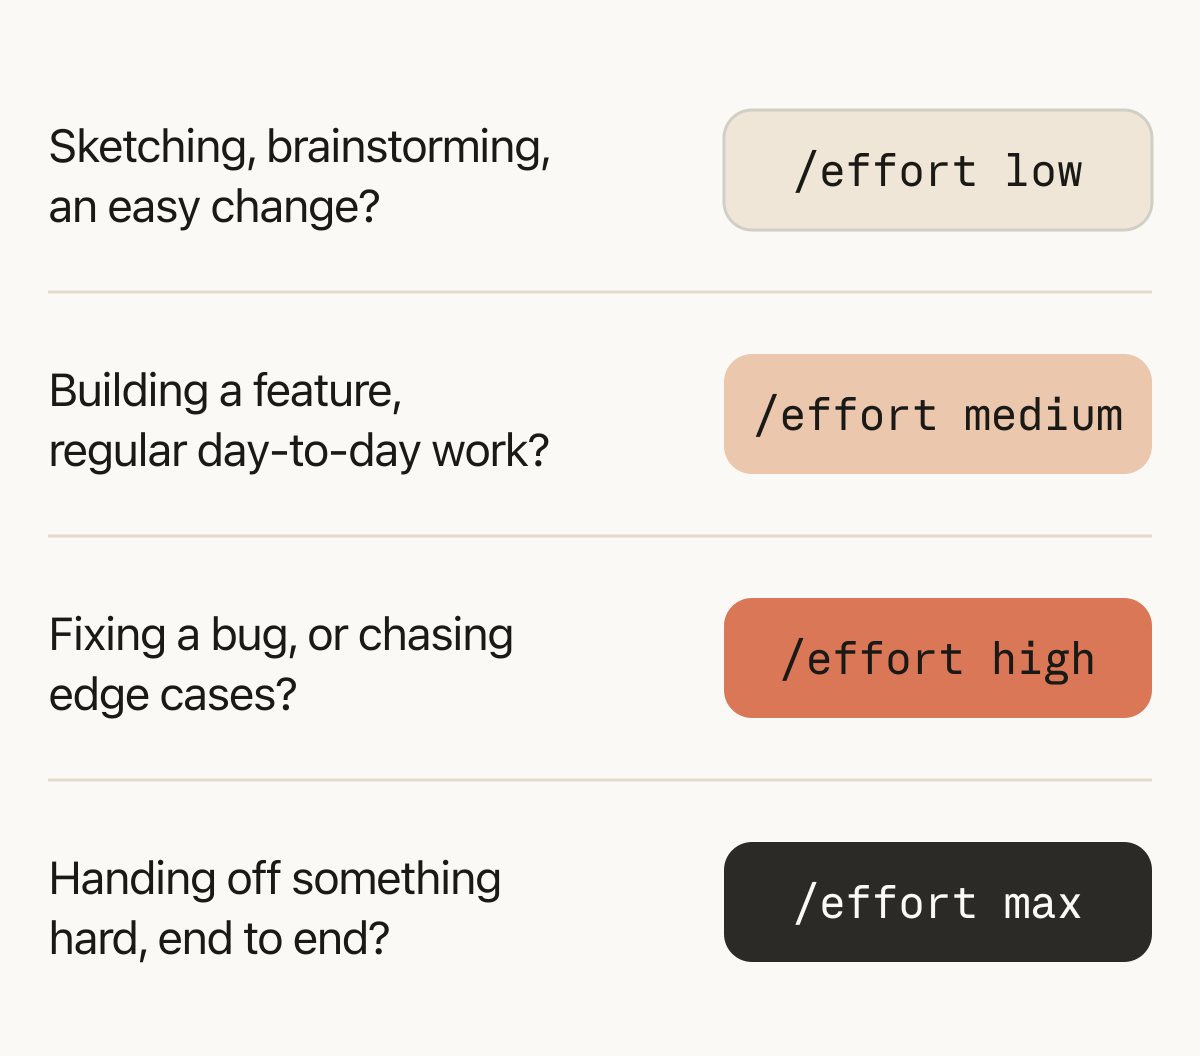
Anthropic 发布 Claude Opus 5.5 提示指南,说明其输出 token 速度比 Claude Opus 5 快 30% 以上,且默认中等努力水平在编码和知识工作评测上可匹配或超过 Claude Opus 5 的高努力水平。指南重点覆盖努力校准、API 与聊天中的思考行为、无人值守智能体运行、安全拒绝、进度更新、多应用工作流、复杂视觉输入和前端设计等场景。
关联讨论 1 条 来源:IT Home本期早报聚焦编码智能体与工程验证:José Valim 认为智能体承担更多编码后,语言应优先强化类型与运行时保证、可查询程序数据库和可探索运行状态;Reddit 工程师 Andrew Orobator 则把可靠编码智能体的关键放在可复用工程判断上,用技能、工作日志、测试和硬门逐步扩大自主权。
作者将 50-100 个工作流从 Fable 5.1 切换到 Opus 5.5 后,发现两者差异很小,但仍因未使用更聪明的模型而产生 FOMO。作者询问有哪些任务人们发现 Fable 5.1 仍比 Opus 5.5 表现更好。
这篇教程围绕 Google Research 的 MSEB 声音嵌入基准展开,从评测器接口的角度解释排行榜数字的含义。作者实现两个刻意不同的编码器——一个测量响度随时间变化、一个测量音色,并在合成语料上驱动分类、聚类、检索和分割四类评测器。结果显示两个编码器在不同评测任务上交替领先,用数字而非文字论证了多任务基准的必要性。
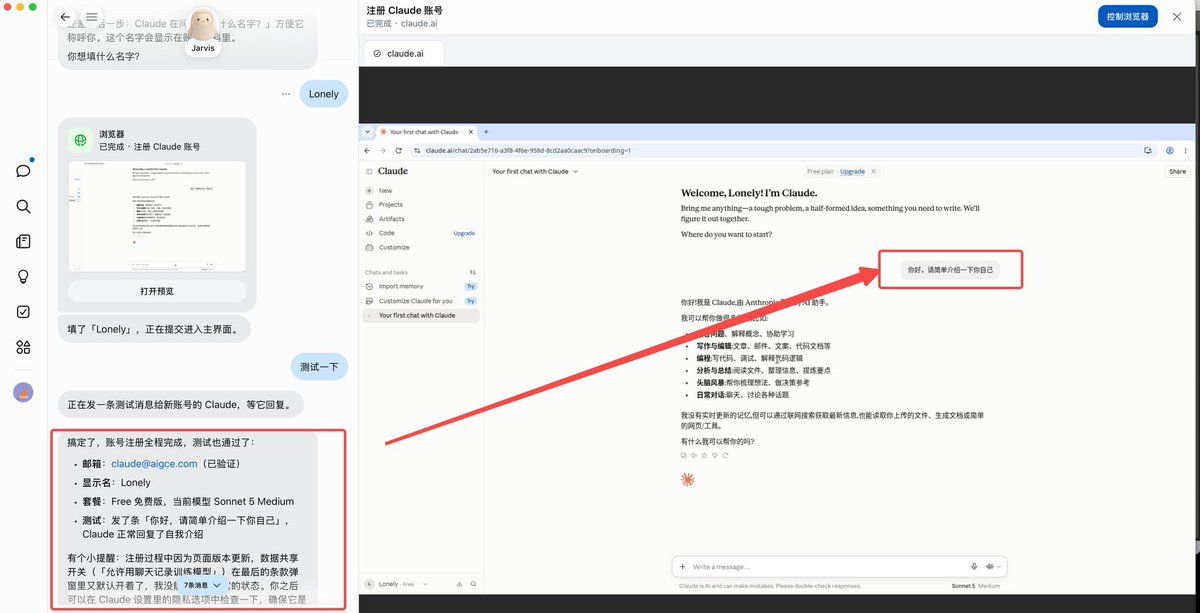
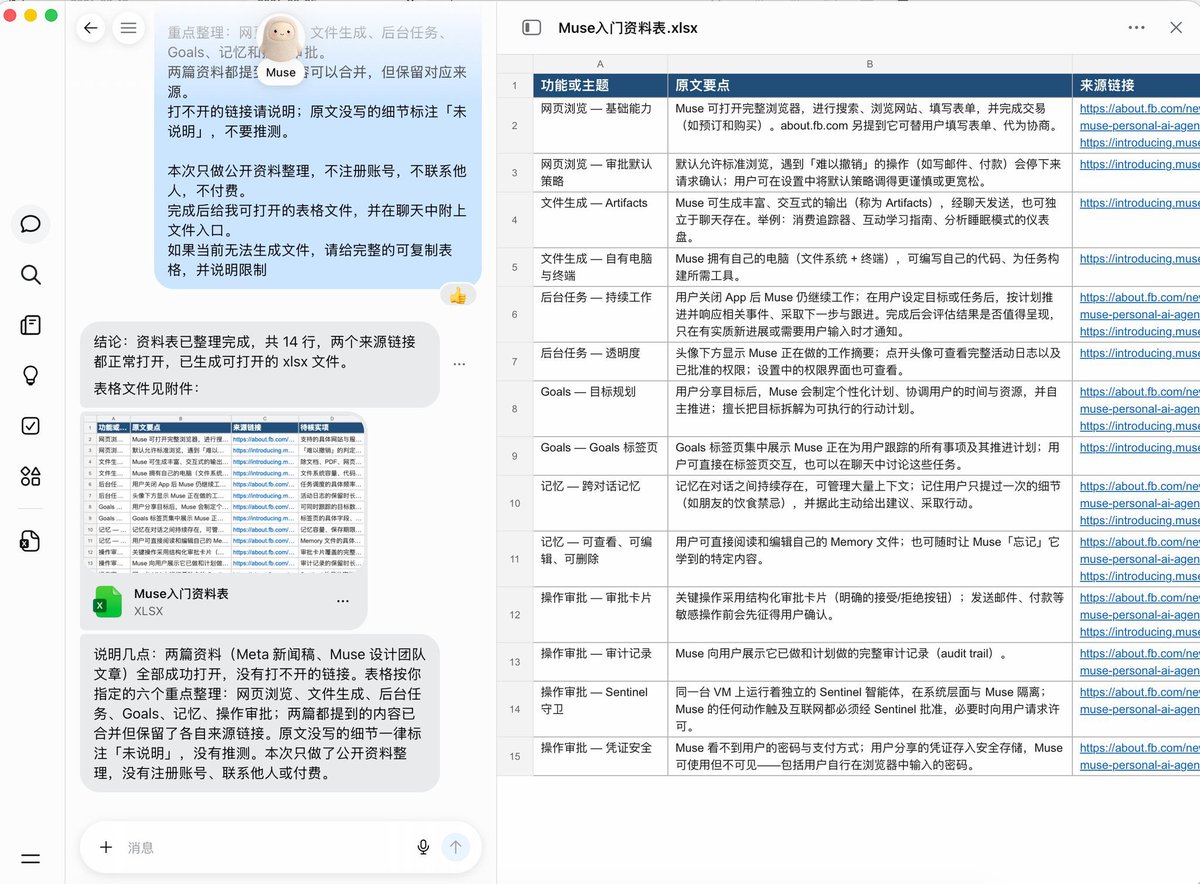
作者看完用 Muse 注册 Claude 的教程后认为,个人 Agent 已开始替人完成注册账号、填表单这类脏活:全程约两分钟,人只负责回答几个问题,其余由 Agent 自己开浏览器、填表、点按钮走完流程,关掉 App 后还能在后台继续。作者还给出几条使用原则,包括先定规矩、给任务设边界、人机验证别死磕、用真实对话验收。
本期早报聚焦智能体相关进展:Parag Agrawal 提出智能体搜索应先筛无关信息以节省推理开销,并按获益向内容所有者付费;Erina Karati 主张用可控场景、运行轨迹和多维评分评估长时程智能体的整段行为,只保留通过护栏的小幅策略改动。
作者在 WeAreDevelopers 北美大会闭幕演讲中,把三张鸮鹦鹉照片交给 Claude Opus 5.5,生成一个至少 20 只鸮鹦鹉跳动的 HTML 5 canvas 像素动画;随后让本地 Claude Code 用 Playwright 加载页面、按时间点点击触发彩带效果,输出 15 秒视频用于最终幻灯片。
DeepSeek 发布 DSec 技术报告,介绍一个生产级沙箱平台,通过统一 SDK 提供 FnCall、容器、microVM 和全 VM 四种后端。单个生产单元约 160 个节点,每天服务约 300 万个沙箱,支持超过 38 万并发沙箱和每秒 5000 次以上沙箱创建。DSec 与强化学习框架协同设计,将状态化 rollout 执行与可抢占 GPU 训练解耦,并缓解奖励黑客等智能体不当行为。
关联讨论 2 条 来源:IT Home来源:微信公众号(Wechat2RSS 自建) (@量子位)Chamath Palihapitiya 介绍了自己为工作和生活定制的 AI 智能体:一个用于高风险谈判的纳什均衡 AI 智能体,一个用于重大人生决策的个人 AI 世界模型。他实际上围绕一个基础模型构建了持久的微服务。
Floci 提供本地云服务模拟器,可在毫秒级启动 AWS、Azure、GCP 和 OCI,无需凭证或云账户。每个模拟器是独立的 MIT 许可原生二进制,冷启动 24 ms、空闲占用 13 MiB,并作为 LocalStack 的直接替代,保持 4566 端口和 119 个服务兼容。
Anthropic 发布 Opus 5.5 配套提示词指南,指出无人值守 Agent 半路停工的主因是模型主动汇报进度后返回 end_turn,而旧程序把纯文本回合结束误判为任务完成。官方归纳了四种停工模式,并给出任务清单、验收模型、强制刹车三招续跑方案。
这篇教程用 AugLy 搭建覆盖图像、文本、音频和 PyTorch 的多模态增强与鲁棒性工作流。作者在图像上基准测试感知哈希复制检测,在文本上评估对抗扰动、Unicode 混淆、清洗与对抗训练,并记录增强元数据与强度,使每个生成样本可追踪。
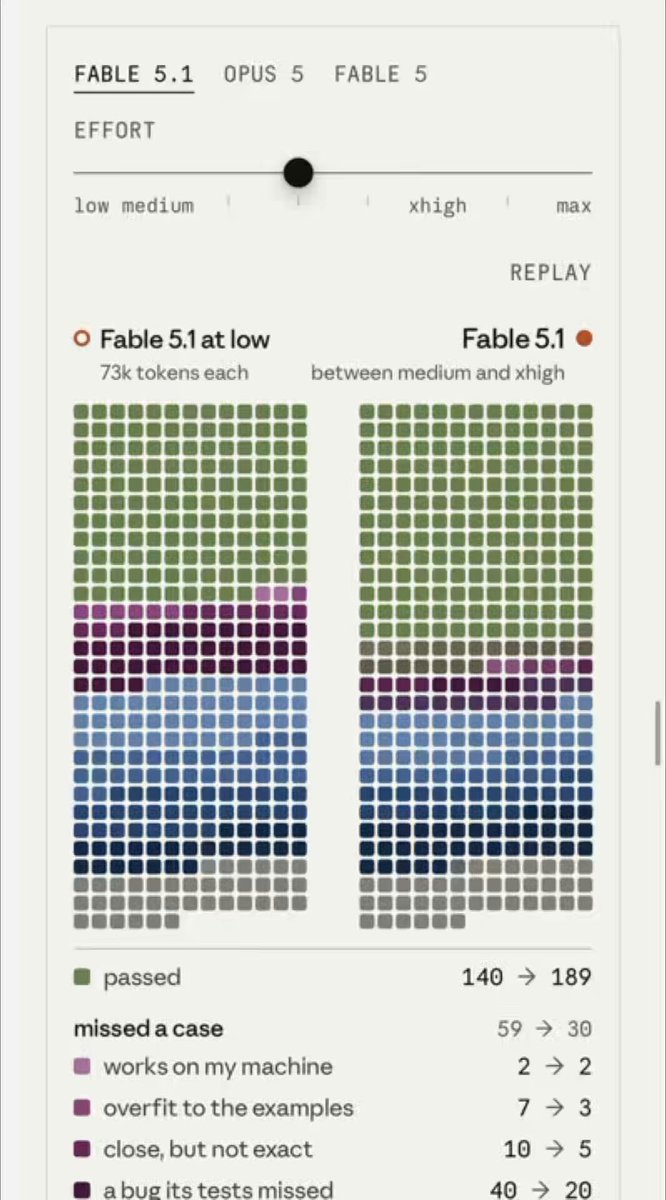
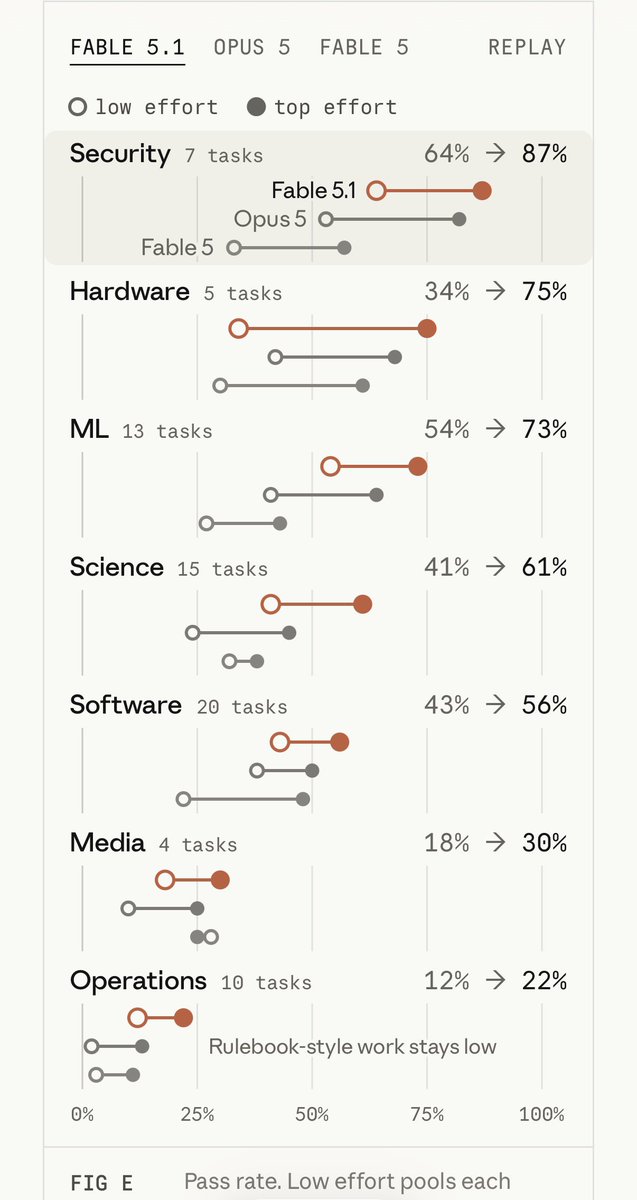
Thariq 对 Claude Code effort 旋钮的解读是:它控制的是模型投入的验证、边角案例挖掘和自主决策程度,而非知识上限。同一会话内可中途切换且不破坏 prompt cache。在 Terminal Bench 3.0 评测中,max 档通过 214 题、中位约 22.2 万 token,low 档通过 140 题、中位约 7.3 万 token;安全领域从 64% 提升到 87%,硬件从 34% 提升到 75%。
Anthropic 工程师 Thariq 复盘 Claude Code 的 effort 旋钮,指出它控制的是模型在当前能力下的工作时长而非聪明程度。内部测试中 Token 消耗从中位 7 万升至 22 万,安全漏洞通过率从 64% 拉到 87%,但架构方向一开始走错时加档也救不回来。模糊需求下 Max 档会跑 67 分钟并塞入多余功能,反而增加返工成本。
本期早报聚焦 AI 工程与产品实践:Stripe CEO 披露一位工程师上半年合并 600 多个 AI 编写的 PR、仅 1 个被回滚,Stripe Projects 由两三位工程师两个月上线并估算至少六倍提速;OpenRouter 服务超 1000 万开发者、日 token 处理量超 10 万亿,并入 Stripe 的关键考量之一是 token 欺诈上月拦截金额为前月 10 倍。
Claude Code 已经能运行测试、类型检查和 linter。这段视频展示如何给它更多验证自身工作的方式,使其能更独立地推进任务,减少来回沟通的轮次。
GitHub Copilot 应用引入 canvas 扩展:用户用 /create-canvas 指令以自然语言描述工作流,智能体即可生成看板、清单、仪表盘等双向共享界面,无需手写代码或布局。生成后可持续修改,并保存为项目或个人的可复用扩展。
作者称 Tag 每天替他写超过 50% 的 PR,并承担约 100% 的数据分析,还修复大部分产品反馈和 bug。Tag 不是普通 Slack bot,而是主动、可编程、有记忆并能访问连接器,在 Opus 5.5 和 Fable 5.1 下具备较强判断力。
Pay attention to System One models if you are building custom harnesses and agentic workflows. Great to see DSPy integrate Jev and now support System One models for calibrating agentic workflows. I'm amazed at how naturally System One models like Jev fit into these frameworks. I am using Jev to build my own custom
这篇文章解释了 AI 工作负载为何会在监控显示 GPU 空闲时仍然排队:低计算利用率不等于设备可被新任务使用,因为分配规则、显存占用、硬件兼容、隔离和放置约束共同决定实际可用性。文章以 Cast AI 2026 年报告中 5% 的平均 GPU 计算利用率作为研究引子,但强调不能据此推断 95% 的容量可立即回收,也不能假设排队与空闲 GPU 出现在同一测量环境中。
关于爆火的Muse,我先说个暴论吧,个人 AI 代理的分水岭,正在从分身矩阵走向一条神线程。 兄弟们别再把 Meta Muse 当成另一个只能写小作文的聊天助手了, 看完了 @AlexFinnis 的 24 分钟Muse深度实测教程,我发现扎克伯格其实在下一盘很毒的棋: 剥掉那些花哨的营销词,扎克伯格这次真正端出来的底牌,根本不是聊天框,而是直接送给每个人一台 24 小时替你上网省钱的云端电脑。 两组方向相反的硬事实撞在一起,才是这个产品最耐人寻味的信号: 一方面是极度凶狠的真实落地能力,连上账单后它自己开浏览器登录账号、扒出隐藏扣费、甚至打电话跟人工客服排队周旋,有人实测一年硬生生省下 480 美元话费,追回过期订阅费,而且
这篇 Muse 入门教程把个人 Agent 当成刚来第一天、手脚勤快但可能脑补交差的实习生来调教,核心原则是先在看得见的视线里让它完整闭环一件能查验对错的小事,权限、记忆、连接器用到再一点点给。文中给出四个反直觉细节:约束比能力重要、交付物必须是能打开的文件、在原对话里打磨、提示词管不住权限。
一篇来自 resobscura.substack.com 的文章介绍了使用大型语言模型追溯炼金术知识、破译17世纪信件的工作,在 Hacker News 上获得100个赞。
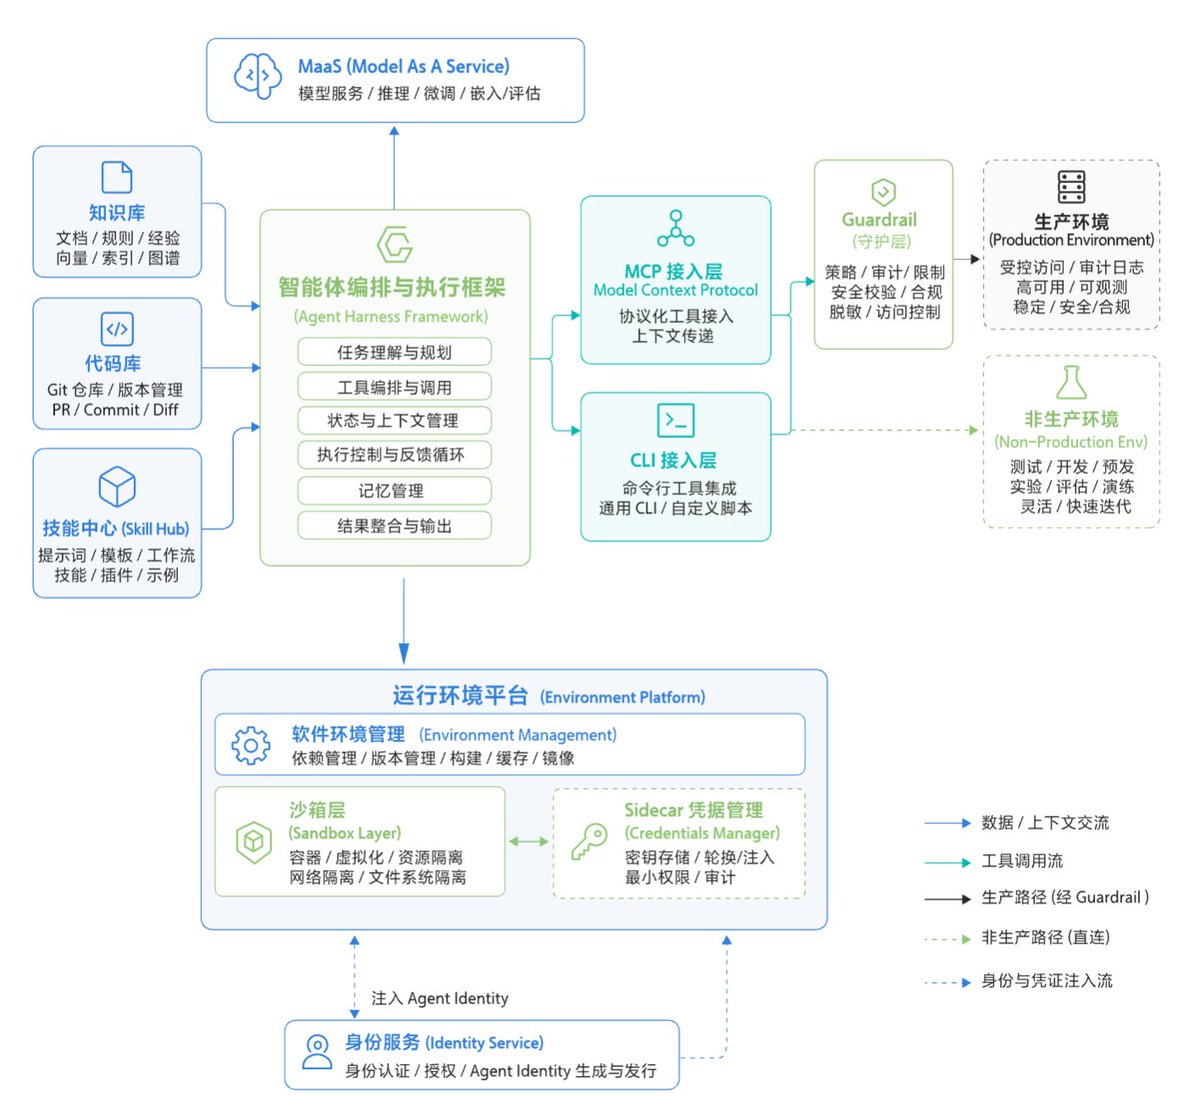
Coding 正在被模型快速解决,研发提效的主战场已从「让 AI 更会写代码」迁移到环境与验证,把「只有人会操作」的内部系统、知识、发布链路,翻译成 Agent 可调用、可验证、可追责的基础设施。 from 阿里巴巴《AI Native 研发范式实践手册》 https://t.co/502Mw4cV13
Stripe CEO Patrick Collison 在访谈中透露,Stripe 约 36% 的 pull request 现在从提示词开始,由 Claude Code 在隔离 dev box 中完成。他还提到一名工程师在六个月内合并了 600 个 AI 写的 pull request,仅有一次回滚,并预期 AI 会提升 Stripe 的代码质量。