06:57
谷歌最前沿 AI 模型:Gemini 4 Argon 登场,长周期代码工程 DeepSWE 测试超 Claude Opus 5.5
IT之家 10 月 1 日消息,谷歌昨日(9 月 30 日)发布 Gemini 4 Argon,称其为公司迄今最先进的 AI 模型,但目前并未面向公众全面开放。 定位方面,Gemini 4 Argon 是谷歌当前“最先进”模型,重点是长流程软件工程、企业知识工作和网络安全防御。官方称其在真实世界软件工程测试创纪录,网络安全基准并列第一,并在金融、法律等专业任务基准领先。 模型特性方面,Gemini 4 Argon 单次输出上限达到约 100 万 tokens,高于此前的 64,000 tokens,适合处理大型代码库、长文档和多阶段任务。 谷歌 DeepMind Gemini 产品负责人 Tulsee Doshi 表示:“Argon
推荐理由: IT Home 发布的新动态包含 AI 产品、模型或工程信号;摘要可帮助先判断是否需要打开原文深读。
06:11
Magnitude(YC S25)发布面向智能体的自优化开源推理引擎
Magnitude 是一个面向智能体的开源推理引擎,会在你的设备上编译并调优内核,使开放模型运行速度最高达到 llama.cpp 的 2 倍。它支持 Apple Silicon、NVIDIA、AMD 或纯 CPU,提供 macOS、Windows、Linux 桌面应用,可一键连接 Pi、OpenCode、Hermes、Codex 等智能体。官方称 Metal 上解码快 92%、CUDA 上快 19%,每个智能体内存占用减少 27%,且提示、文件和模型均留在本机。
推荐理由: Magnitude 给出了与 llama.cpp 的对比基准、内存节省和本地隐私承诺,读者可以据此评估是否替换现有推理后端。
06:06
Google Gemini 4 Argon 缩小与 OpenAI 和 Anthropic 的差距,但未取得明显领先
Gemini 4 Argon 是 Google 七个多月来首个前沿模型。独立测试中它追平 GPT-6 Astra,但不及 Anthropic 的 Claude Opus 5.5。每 token 价格虽低,但每个任务消耗的 token 数是 Astra 的两倍多。首批仅限特定测试者访问,API 和付费层级随后开放。
推荐理由: Google 公布了 Gemini 4 Argon 的独立测试对比、token 消耗与分阶段开放安排,读者可据此评估其性价比和可用时间。
05:30
Google DeepMind 发布 Gemini 4 Argon:单次响应可输出 100 万 token,面向编码、知识工作和网络防御
Google DeepMind 发布 Gemini 4 Argon,单次响应最多可生成 100 万 token,此前 Gemini 模型为 64K。该模型面向长周期软件工程、法律与金融企业知识工作以及网络安全防御。定价为输入每百万 token 2 美元、输出 10 美元,优惠期后升至 4 美元和 20 美元。
推荐理由: Google DeepMind 公布了 Argon 的输出上限、定价和 18 项基准对比,读者可以据此评估长输出任务的实际成本与能力边界。
05:09
OpenAI 发布 GPT-6.1 Sol:编码与计算机使用接近 Astra,价格仅为其五分之一
OpenAI 发布 GPT-6.1 Sol,定位 GPT-6 家族中端模型,在 DeepSWE v1.1 编码基准上以约五分之一成本追平 GPT-6 Astra,并比 GPT-6 Sol 最佳成绩高 6.4 个百分点。标准 API 定价为每百万 token 输入 2 美元、输出 10 美元、缓存输入 0.10 美元,缓存输入较 GPT-6 Sol 降低 50%。
推荐理由: OpenAI 公布了 GPT-6.1 Sol 的定价、基准成绩和 API 可用渠道,读者可以据此对比 Astra 与 Claude Opus 5.5 的成本效率。
04:41
Google 发布 Gemini 4 Argon,初期仅限“可信网络防御者”使用
Google 公布下一代前沿模型 Gemini 4 Argon,称其在软件工程、法律金融等企业知识工作和网络安全防御等复杂工作流中达到前沿性能。初期访问仅限一组“可信网络防御者”,Google 表示正参与美国政府预发布模型访问的自愿流程,并将在更广泛推出前加强关键前沿防护。
推荐理由: Google 给出了 Gemini 4 Argon 的发布信息、初期访问限制和基准对比,读者可以据此判断其能力定位与开放节奏。
04:20
Google 发布 Gemini 4 Argon:面向网络防御者的新一代前沿模型
Google 宣布推出前沿模型 Gemini 4 Argon,先通过 Fairwind Program 向可信网络防御者开放。该模型在 DeepSWE v1.1 软件工程基准上取得 77.9%,在长视频理解 LVBench 上取得 91.7%,在 CWE-bench v1 漏洞修复上以 68% 并列第一。定价为每百万输入 token 2 美元、每百万输出 token 10 美元,输出上限从 64K 提升至 1M token。
推荐理由: Google 公布了 Gemini 4 Argon 的基准成绩、定价和分阶段发布安排,读者可以据此对照其软件工程与安全防御能力。
04:01
Google 发布 Gemini 4 Argon:面向长程推理与网络安全防御的前沿模型
Google 宣布推出前沿模型 Gemini 4 Argon,先通过 Fairwind Program 向可信网络防御者开放。该模型在 DeepSWE v1.1 得 77.9%、LVBench 得 91.7%、CWE-bench v1 得 68%,并在 Google 内部量子算法优化中将已发布基线提升 40%。输出 token 上限从 64K 扩至 1M,定价为每百万输入 token 2 美元、输出 10 美元。
推荐理由: Google 公布了 Gemini 4 Argon 的评测成绩、内部应用案例与分阶段发布安排,读者可以据此对照其长程推理和网络安全防御能力。
03:12
OpenAI 与 Synopsys 合作开发 GPT-Synopsys,让 AI 像资深工程师一样设计芯片
OpenAI 与 Synopsys 正在联合开发 GPT-Synopsys,这是一款面向芯片设计的专用 AI 模型,目标是像资深工程师一样操作 Synopsys 的 EDA 工具并自主优化设计。目前该模型已开始与半导体客户进行早期测试。
推荐理由: OpenAI 公布了 GPT-Synopsys 的合作方向与早期测试状态,读者可以据此判断 AI 进入芯片设计工具链的落地进度。
03:10
Claude Code v2.1.286 发布:修复大量 MCP、远程控制与凭据脱敏问题
Claude Code v2.1.286 发布,集中修复了 MCP 错误信息泄露凭据值、Bearer 令牌部分脱敏、远程控制会话在策略关闭后仍保持连接等问题。同时改进权限提示、全屏列表鼠标操作和 VSCode 书签功能。
推荐理由: Anthropic 发布了 Claude Code 的版本更新日志,涵盖 MCP、远程控制、凭据脱敏和 VSCode 集成等修复,读者可以据此核对自身环境是否命中相关缺陷。
03:00
OpenAI 推出 Decisions API,对标 TypeSafe 的 Jev 快速决策模型
OpenAI 在 Dev Day 上公布了 Decisions API,功能类似 TypeSafe AI 本月发布的 Jev 模型:让模型在预定义选项中输出概率,以极快速度和低成本完成分类或智能体行为选择。Altman 称聚焦选择可保持图像理解、多语言支持和安全保护。Jev 用于监控智能体动作时成本为 2.94 美元,而前沿 LLM 需 372 美元。
推荐理由: OpenAI 给出了 Decisions API 的定位与 Jev 的对比线索,读者可以据此判断快速决策模型在智能体监控上的成本差异和落地可能。
02:32
FRAC:用分数阶状态转移为长序列建模引入幂律长记忆
论文提出 FRAC,一种基于分数阶动力学的选择性状态空间模型架构,用幂律长记忆替代传统 SSM 的指数遗忘。FRAC 以有限状态、对数间隔的指数模态之和近似重尾目标核,实现并行训练与预填充,同时保留有界状态的自回归解码。在含 1.3B 参数语言建模的实验中,FRAC 在长上下文性能上持续优于最先进的 SSM 基线,短上下文保持竞争力。
推荐理由: 论文给出了 FRAC 的架构思路、近似方法和 1.3B 参数实验结论,说明分数阶动力学可作为长上下文 SSM 的有效先验。
02:23
AI 语音初创 ElevenLabs 估值翻倍至 220 亿美元
ElevenLabs 宣布允许员工以 220 亿美元估值出售部分既得股权,较今年 2 月融资时的 110 亿美元翻倍。此次 3 亿美元员工要约收购由 Wellington 和 T. Rowe Price 共同领投。这是该公司第二次为员工提供二级交易,上一次是 2025 年 9 月以 66 亿美元估值完成的 1 亿美元要约。
推荐理由: ElevenLabs 给出了估值、要约金额和领投方,读者可以据此对照其 2 月融资与 9 月要约的估值变化。
02:16
Google 用 Skills 取代 Gems,加入 OpenAI 与 Anthropic 的智能体就绪提示词格式转向
Google 正在 Gemini 聊天中用 Skills 取代 Gems。Skills 是详细、可复用的提示词,用户输入“/”即可调用,或由 Gemini 自动运行,其格式基于 Anthropic 的开放标准。Gems 将从 11 月起逐步淘汰,现有 Gems 会自动迁移。
推荐理由: Google 公布了 Gems 向 Skills 迁移的时间表与自动迁移方式,读者可以据此评估现有 Gemini 提示词工作流在 11 月前后的兼容性变化。
02:07
AI 电子宠物要来了:Meta 和 OpenAI 押注可爱硬件
Meta 和 OpenAI 计划在未来一年内推出专用 AI 硬件,路径都是先用可爱软件智能体测试市场。OpenAI 与 Jony Ive 合作的设备不早于 2027 年 2 月发货,Meta 的 Muse Charm 吊坠式设备目标在今年假日购物季前推出。此前 Friend 和 Humane AI Pin 等专用 AI 设备主要引发失望和反弹。
推荐理由: 原文给出了 Meta 与 OpenAI 硬件的时间表、形态和软件先行策略,读者可以据此对照两家公司切入实体 AI 设备的不同节奏。
01:45
Reddit 因 AI 爬取滥用终止 RSS 支持,并宣布 2027 年 3 月关闭公共 API
Reddit 宣布将于 11 月 13 日终止 RSS 支持,理由是 RSS 已成为大规模抓取和自动化滥用的常见入口。同时,Reddit 计划在 2027 年 3 月关闭公共 API,影响依赖程序化访问 Reddit 对话的研究工具、社交聆听产品和 AI 助手。
推荐理由: Reddit 给出了 RSS 与公共 API 的关闭时间表和替代迁移建议,读者可以据此评估对依赖 Reddit 数据的研究或 AI 工具的影响。
01:24
The ugly economics of consumer AI
There’s a reason frontier labs have gotten gun-shy about consumer AI — and it’s not because the tech isn’t good enough.
推荐理由: TechCrunch AI 发布的新动态包含 AI 产品、模型或工程信号;摘要可帮助先判断是否需要打开原文深读。
01:22
Meta 将 AI 数据中心归类为“实验”以规避数十亿美元美国税款
Meta 将 AI 数据中心归类为“试点模型”、把 Nvidia 芯片列为实验材料,以此节省联邦税款,仅 2025 年就累计 39 亿美元。该税收抵免可追溯至 1981 年,Meta 自己的会计师也认为这一策略存在法律风险。
推荐理由: Meta 给出了数据中心与芯片的税务归类口径及 2025 年 39 亿美元节税规模,读者可以据此评估其税务策略的法律风险。
01:15
AI 领袖如何回应特朗普的新安全计划:自我监管取代联邦法规
特朗普周二与六位科技领袖会面后,宣布以“道德约束”性质的《前沿责任联合承诺》取代联邦 AI 监管,由企业自行监管自身 AI 技术,且违反协议似乎没有后果。签署者包括 Sundar Pichai、Dario Amodei、Mark Zuckerberg、Greg Brockman、Elon Musk 和 Jensen Huang,六人均公开称赞这一自我监管方案。
推荐理由: 原文收录了六位签署者各自的现场表态,读者可以对照不同公司对自我监管与 AI 风险的措辞差异。
01:00
NVIDIA 开放 2027-2028 研究生奖学金申请,最高资助 6 万美元
NVIDIA 研究生奖学金项目进入第 26 年,现面向全球开放 2027-2028 学年申请,每名学生最高可获 6 万美元资助。申请者须在提交时已完成至少一年博士学习,并须在 2027 年暑期到 NVIDIA 研究办公室完成强制实习。申请截止日期为 2026 年 10 月 30 日。
推荐理由: NVIDIA 公布了奖学金金额、申请截止日期和强制实习要求,读者可以据此判断自己是否符合申请条件。
00:59
Databricks 推出 ai_decide:在受治理数据上做快速决策的 AI 函数
Databricks 发布新的 AI 函数 ai_decide,由决策模型驱动,可在几分之一秒内对文本评估一个或多个问题,并返回概率、命名标准中的选项或有序评分。它面向模型路由、文档处理、智能体评估等场景,相比 LLM 在类似任务上延迟和成本更低。目前以 Beta 形式提供,可通过 SQL 或 REST API 调用。
推荐理由: Databricks 公布了 ai_decide 的可用方式、返回类型和三类典型用例,读者可以据此判断它是否适合替代现有 LLM 分类或评分流程。
00:48
分块 KV 缓存压缩引入相位敏感:长上下文检索准确率可相差 40 个百分点
一项研究指出,分块 KV 缓存压缩会引入新的位置坐标——token 相对压缩窗口边界的相位,同一信息在不同相位上的检索难度存在系统性差异。在采用此类压缩的大规模开放权重模型中,长上下文检索准确率跨相位最多可相差 40 个百分点,平均基准分数可能掩盖这些周期性弱点。作者从头预训练了多个采用不同 KV 压缩设计的 transformer,并借助因果干预发现不同注意力组件对检索不同源相位信息的贡献不对称。
推荐理由: 该论文给出了相位敏感现象的量化结果与因果干预分析,说明评估分块 KV 缓存压缩模型需要跨相位测量,而非只看平均准确率。
00:46
如何规模化智能体应用而不制造 AI 蔓延
Databricks 与 OpenAI、Stellantis 讨论企业规模化智能体应用时提出,基础设施需提供选择、上下文和控制三项能力。Databricks 用 Agent Bricks、Omnigent 和 Unity Gateway 分别承担统一平台、跨框架组合和集中管控,避免每个智能体各自形成独立集成与治理项目。
推荐理由: Databricks 给出了企业级智能体基础设施的三层拆解,读者可以据此对照自身在权限、上下文和成本控制上的缺口。
00:45
Can companies like OpenAI keep getting away with what they are doing? An interview with Fordham law professor Zephyr Teachout
An interview (my questions in italics) with Zephyr Teachout, attorney, author, and law professor that could not be more timely: What’s your background, legal and otherwise, and what makes you interested in these issues? I’m a law professor at Fordham Law School, I’ve drafted tech legislation that has been enacted and p
推荐理由: Gary Marcus 发布的新动态包含 AI 产品、模型或工程信号;摘要可帮助先判断是否需要打开原文深读。
00:38
人工智能竞赛突然变得尴尬了
The AI Race Just Got Awkward ( insufferable.dev ) 09-30 ↑ 179 HN Points
推荐理由: Hacker News popular via buzzing.cc 发布的新动态包含 AI 产品、模型或工程信号;摘要可帮助先判断是否需要打开原文深读。
00:33
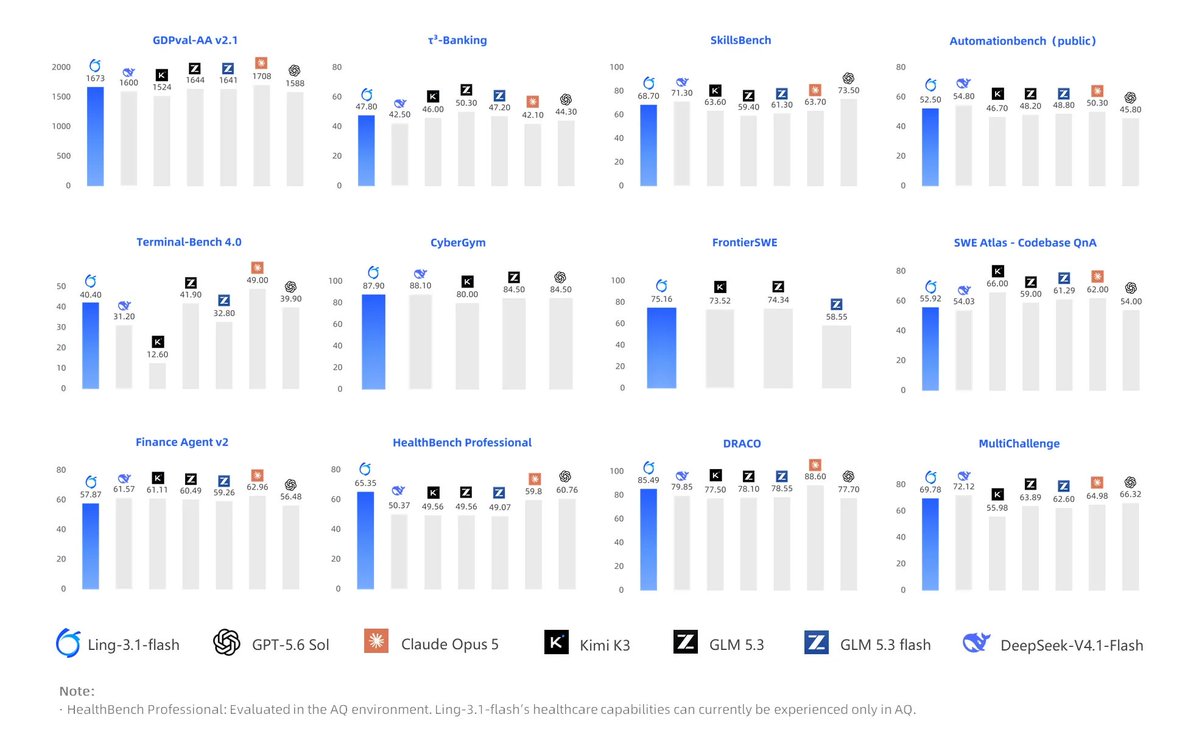
Ling-3.1-flash 发布:约 560B 总参数、25B 活跃参数,计划开源
Ling-3.1-flash 公布,总参数约 560B、每 token 活跃参数约 25B,上下文最高 1M token。官方计划近期开源。该模型在 GDPVal-AA v2.1 上取得 1,673 Elo,FrontierSWE 得分 75.16,HealthBench Professional 得分 65.35。
推荐理由: Ling-3.1-flash 给出了参数规模、三项评测分数和开源计划,读者可以据此对照同类 MoE 模型的工作、编码与医疗表现。
00:29
Ideogram 发布 4.5 图像模型,主打精准编辑,2K 原生分辨率每张 0.8 至 22 美分
Ideogram 发布了 Ideogram 4.5 图像模型,主打精准编辑。该模型已在 Ideogram 平台、API 及合作服务上线,团队还计划很快公开模型权重。原生 2K 分辨率下,每张图像价格在 0.8 到 22 美分之间。
推荐理由: Ideogram 给出了 4.5 模型的发布渠道、开放权重计划和 2K 定价区间,读者可以据此评估其编辑能力与调用成本。
00:29
Ideogram 4.5 上线 Krea,主打可重复编辑
Ideogram 4.5 已上线 Krea。该模型针对重复编辑场景设计,旨在解决多次编辑通常产生的伪影、像素偏移和色彩漂移问题。
推荐理由: Ideogram 4.5 给出了重复编辑场景的改进方向,读者可以据此对比现有图像编辑工具在多次编辑后的稳定性。
00:24
Meta 否认 Muse AI 未经许可读取用户私信,称消息集成完全需用户主动开启
Meta 反驳记者 Jason Aten 关于 Muse AI 在 Mac 上未经许可读取其私信的指控。Meta 通讯副总裁 Andy Stone 表示,Muse 的 Messages 集成完全可选,用户必须同时开启 Full Disk Access 和 Messages 连接器,否则无法读取消息内容。Meta 高管还称相关权限涉及三步应用级授权和 macOS 系统级保护,即使应用存在漏洞也无法绕过。
推荐理由: Meta 给出了 Muse 读取消息所需的具体权限步骤和系统保护说明,读者可以据此对照记者描述判断双方说法差异。
00:21
Org-Agent:面向组织场景的多用户智能体约束推理框架
arXiv 论文提出 Org-Agent,一个面向组织场景的约束中心推理框架,将任务分解为原子子任务并构建依赖图,按拓扑顺序调度执行,同时处理用户身份、权限、信息时效与冲突解决等组织约束。在 MUSES-Bench 和 GroupMemBench 上的实验验证了其在跨用户交互决策与跨用户记忆知识使用两项能力上的有效性,消融实验支持依赖建模与工具使用的贡献。
推荐理由: Org-Agent 给出了任务分解、依赖图与约束执行的三阶段框架设计,论文指出跨用户记忆与决策受身份、权限和时效约束,可据此评估组织型智能体的实现路径。
00:21
TPU 上加速视频扩散的时空稀疏注意力:1440p 生成端到端提速 1.69 倍
开发者将 Sparse VideoGen 的时空稀疏注意力在 TPU 上落地,通过跳过空 tile、仅对边界 tile 做精确掩码、把 token 布局改为时间主序,把 1440p 视频生成的去噪时间从 2471 秒降到 1461 秒,实现 1.69 倍端到端推理加速,同时保持 24.05 dB PSNR。
推荐理由: 原文给出了从算法稀疏到 TPU 硬件加速的完整优化路径,读者可以对照 720p、1080p、1440p 三档分辨率的提速与 PSNR 数据评估稀疏注意力的实际收益。
00:20
FTC 对 OpenAI、Anthropic 等 AI 实验室发起消费者保护调查
美国联邦贸易委员会(FTC)正式调查 OpenAI、Anthropic 及其他头部 AI 实验室,关注其是否存在消费者保护违规。FTC 计划通过具有法律约束力的要求强制企业交出文件和高管证词。该调查在 Hugging Face 遭黑客攻击前已启动,范围超出此前要求企业为其智能体行为担责的举措。
推荐理由: FTC 公布了调查范围、强制取证手段和时间线索,读者可以据此判断监管对头部 AI 实验室的介入程度。
00:12
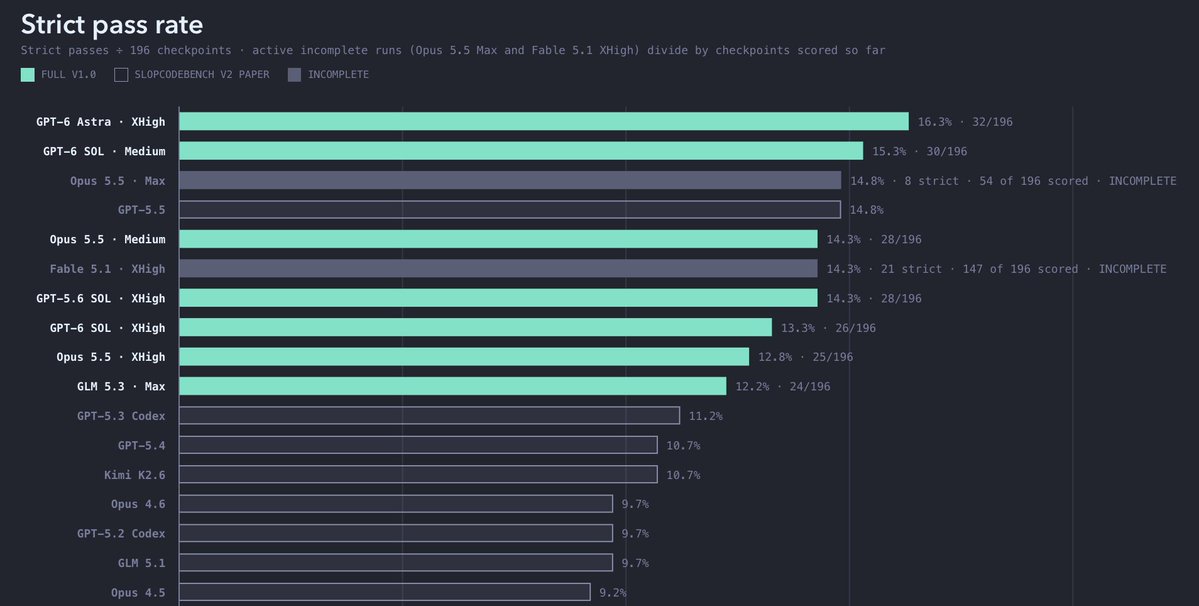
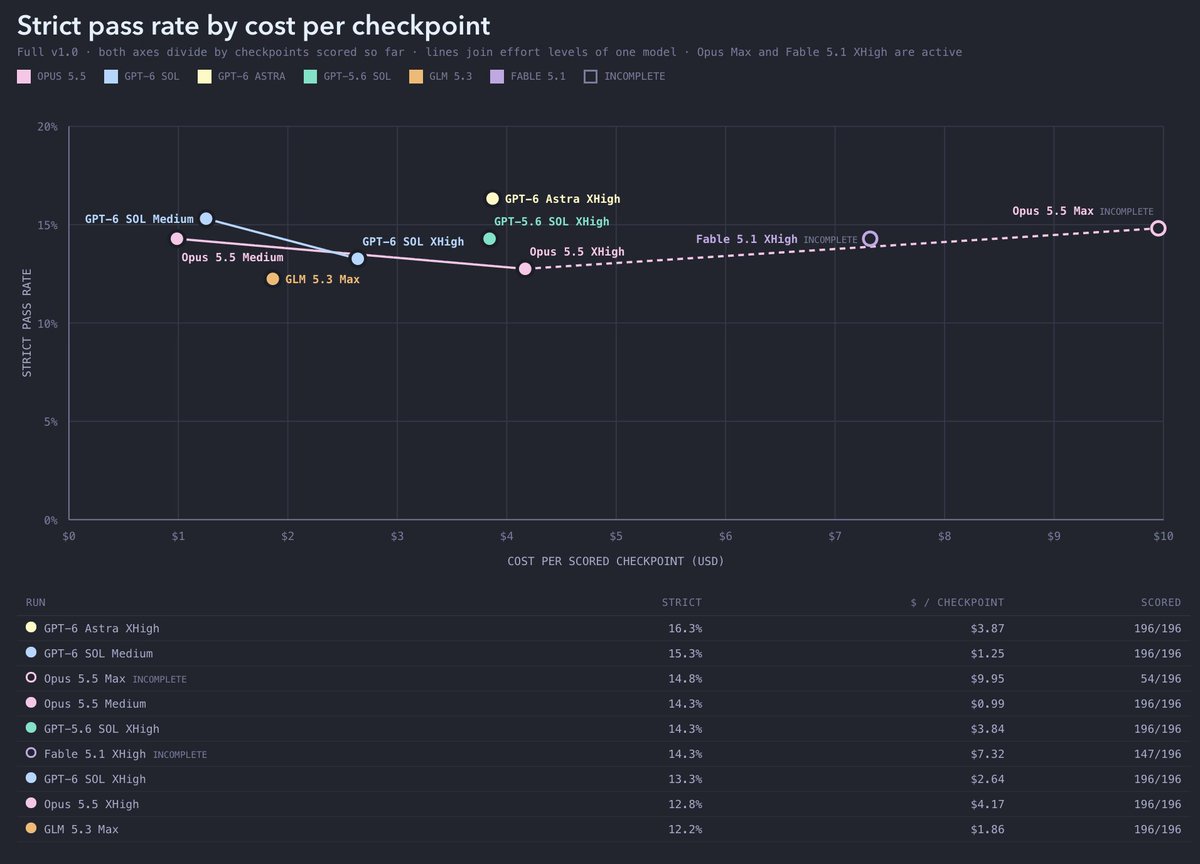
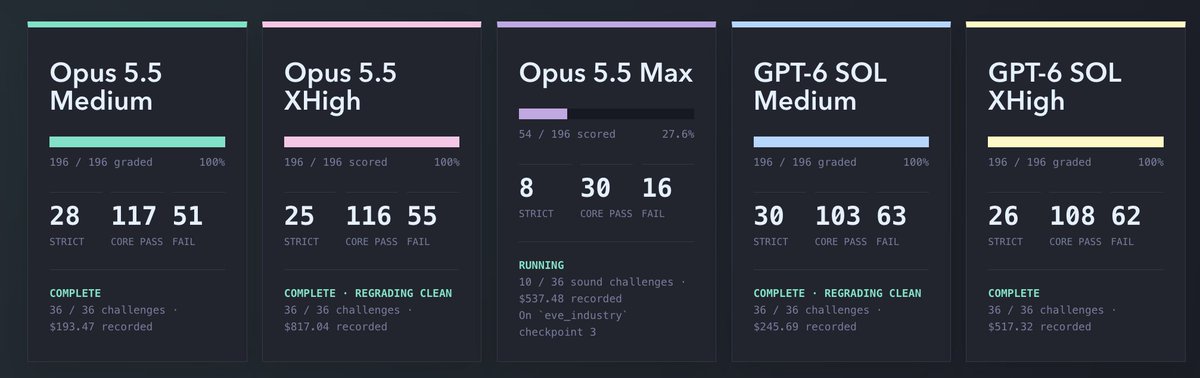
y'all keep releasing models faster than I can bench them, but here's the latest pending results for SCB on Sol 6, Opus 5.5, and more (5.5 Max still chugging along) https://t.co/ZDTxKMIvS5
y'all keep releasing models faster than I can bench them, but here's the latest pending results for SCB on Sol 6, Opus 5.5, and more (5.5 Max still chugging along) https://t.co/ZDTxKMIvS5
推荐理由: X:Dex Horthy(HumanLayer) 发布的新动态包含 AI 产品、模型或工程信号;摘要可帮助先判断是否需要打开原文深读。
00:07
智能体能替其他智能体设计好用的代码库吗?LibraryDesignBench 给出评测
一项研究提出 LibraryDesignBench,用两阶段基准评测智能体为其他智能体设计代码库的能力:设计者按规格实现库,再由三个不同模型家族的用户智能体基于该库写程序,以正确性和简洁性衡量库的质量。基准覆盖 4 种语言、15 个库设计任务、242 个专家验证的编程问题。结果显示,15 个任务中有 11 个设计者复现了人类生产库的抽象;下游智能体对智能体写的库和人类写的库采用率相近,但都使用不足,会重新实现库已提供的能力。
推荐理由: 原文给出失败分析:下游智能体多写代码主要因为智能体写的库僵硬或难用,而非能力缺失,读者可据此判断库设计瓶颈所在。
00:04
微软研究院用机器学习提前30-60分钟预测太空天气对电网的损害位置
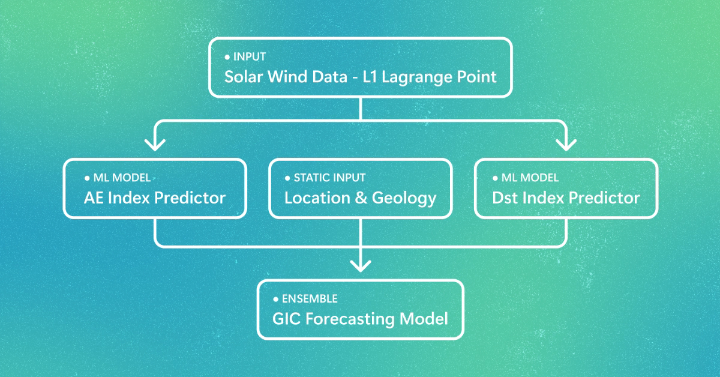
微软研究院开发了一个机器学习系统,可提前30-60分钟预测太空天气对美国本土66935个变电站的损害风险。该系统结合太阳风观测、AE和Dst指数预报、地质导电率和电网数据,在评估期内检测到近80%的重大太空天气事件。
推荐理由: 微软研究院公布了该系统的检测率、误报率和推理耗时数据,读者可以据此评估其用于电网运营前的验证差距。
00:04
Gemini 推出 Skills:把重复提示词存成快捷指令,直接跳到结果
Gemini 推出 Skills 功能,将针对特定任务的指令保存为可复用的快捷方式,用户无需反复输入相同提示词即可直接获得结果。原文仅给出这一功能描述,未提供可用范围、设置方式或效果数据。
推荐理由: Gemini 公布了 Skills 这一功能定位与用途说明,读者可以据此判断它是否适用于自己重复执行的提示任务。
00:00
DoorDash 推出可发短信点餐的 AI 智能体
DoorDash 周三宣布推出文本点餐 AI 智能体,用户可通过 Apple Messages 发送“点我常点的”等指令,智能体会理解其指周五晚上的订单,并支持指定菜品、本地推荐、发送食物照片,以及处理多人混合饮食偏好和不同数量。该功能在美国开放候补名单。
推荐理由: DoorDash 公布了文本点餐智能体的交互方式、候补入口和无人机测试计划,读者可以据此对比 Uber Eats 与 Grubhub 的跟进节奏。